



base model에서 뽑은 샘플만 있으면, KL 제약 아래 RL alignment이 올릴 수 있는 reward의 상한을 학습 시작 전에 숫자로 구할 수 있다. 이 상한 대비 best-of-N은 98% 이상을 얻었고, safety 과제의 GRPO는 77%, PPO는 75%에서 멈췄다 [1]. Apple 저자들은 KL-regularized alignment의 최적 reward 이득이 Jeffreys divergence로 정확히 표현된다는 닫힌 형태(closed form)를 유도했다. 그다음 이 양을 base model 분포 위의 covariance로 바꿔 써서, 정렬된 모델 없이 추정하는 길을 열었다 [1]. 같은 식 안에서 reward hacking의 발생 이유와 reward model ensemble이 듣는 이유도 증명으로 따라 나온다 [1].
RL로 모델을 정렬해 본 사람이면 겪는 답답함이 있다. reward가 어느 선에서 더 안 오르는데, 그게 알고리즘 한계인지 base model이나 reward model 한계인지 구분이 안 된다. 보통은 PPO를 GRPO로 갈아끼우거나 hyperparameter를 돌리면서 알고리즘 쪽을 만지는데, 정작 상한선이 어디인지는 모르고 한다. 이 논문이 좋았던 건 그 상한선을 학습 전에 숫자로 그릴 수 있게 했다는 점이다. 이 메모는 2026년 10월에 arXiv 원문을 읽으면서 본문, 정리(theorem), 부록 표의 숫자를 하나씩 맞춰 본 기록이다 [1]. 모델과 데이터가 공개돼 있긴 해도 나는 실험을 다시 돌려 보지 않았다. 저자들과 얽힌 이해관계는 없다.
RL alignment의 천장은 어디인가
답부터 적으면, 최적 정렬 모델이 base model 대비 추가로 얻는 reward는 벌점 계수 λ와 두 분포 사이 Jeffreys divergence의 곱과 정확히 같다 [1]. 문제 설정은 RLHF 계열이 다 공유하는 KL-regularized 목적이다. reward model $r$은 답 $y$를 채점하고, 정책이 base model $\pi_{\text{base}}$에서 멀어지는 정도는 KL divergence 항으로 벌한다 [1].
\[\pi_{r,\lambda} = \arg\max_{\pi}\; \mathbb{E}_{y\sim\pi(\cdot|x)}[r(x,y)] - \lambda\,\mathrm{KL}(\pi\,\|\,\pi_{\text{base}})\]이 최적화의 해는 이미 알려진 꼴이다. base model 확률마다 reward를 지수로 올린 값을 곱하고, 전체 합이 1이 되도록 나누면 된다 [1].
\[\pi_{r,\lambda}(y\mid x) = \frac{\pi_{\text{base}}(y\mid x)\,e^{r(x,y)/\lambda}}{Z_{r,\lambda}(x)},\qquad Z_{r,\lambda}(x)=\mathbb{E}_{y\sim\pi_{\text{base}}}\!\left[e^{r(x,y)/\lambda}\right]\]$\lambda$는 KL 벌점을 얼마나 세게 거느냐를, $Z$는 정규화 상수를 뜻한다. 이 해로 reward가 정확히 얼마 오르는지는 지금까지 부등식 수준에서만 다뤄졌다. 경험적으로는 Gao 등이 reward 이득과 KL 제곱근 사이의 대략적 비례를 관찰했다 [2]. 이론 쪽에서는 Mroueh와 Nitsure가 reward의 sub-Gaussian 가정을 두고 그 제곱근 꼴이 상한이라는 걸 보였다 [3]. Theorem 1은 이런 분포 가정을 두지 않고 부등호를 등호로 바꾼다 [1].
\[\mathbb{E}_{\pi_{r,\lambda}}[r] - \mathbb{E}_{\pi_{\text{base}}}[r] = \lambda\,\mathrm{JD}(\pi_{\text{base}}\,\|\,\pi_{r,\lambda}),\qquad \mathrm{JD}(P\|Q)=\mathrm{KL}(P\|Q)+\mathrm{KL}(Q\|P)\]$\mathrm{JD}$, 곧 Jeffreys divergence는 앞방향 KL과 뒷방향 KL을 더한 값이다. 그러니 reward 이득은 base에서 떨어진 거리를 양쪽 방향으로 모두 잰 다음 λ를 곱한 것이고, KL 한 방향의 제곱근만으로는 이 값이 나오지 않는다 [1]. 제곱근 법칙은 어림이었고, 여기서는 등식이 성립한다.
그 천장을 학습 전에 계산할 수 있나
할 수 있다. 문제는 Theorem 1의 우변을 계산하려면 정렬이 끝난 모델이 필요하다는 점인데, 저자들은 이 양을 base model 위의 covariance로 바꿔 써서 그 의존을 없앴다 [1]. Theorem 2에서는 학습용 reward $r$과 평가용 reward $r’$을 따로 두고, 둘이 같은 경우와 다른 경우를 식 하나로 묶는다 [1].
\[\Delta(r, r') = \mathbb{E}_{\pi_{r,\lambda}}[r'] - \mathbb{E}_{\pi_{\text{base}}}[r'] = \mathrm{Cov}_{\pi_{\text{base}}(\cdot|x)}\!\left(r',\; \frac{e^{r/\lambda}}{\mathbb{E}_{\pi_{\text{base}}}[e^{r/\lambda}]}\right)\]$\mathrm{Cov}{\pi{\text{base}}}$는 base model 샘플 위에서 잰 covariance다. 오른쪽 인자는 샘플 하나하나에 매겨지는 지수 가중치다. 나는 이 식을 이렇게 읽었다. 최적 alignment이 하는 일은 base model이 원래 낼 수 있던 답들 중 reward가 높은 것에 무게를 더 싣는 것뿐이다. 따라서 base 샘플에 reward 점수만 붙여 두면, 그 재가중으로 reward가 얼마나 오를지 학습 없이 미리 계산된다.
추정 방법도 함께 나온다. Definition 1은 이 covariance의 Monte Carlo 추정량이고, Definition 2는 같은 샘플로 KL divergence를 추정하는 식이다. 두 추정량 모두 샘플이 많아질수록 참값에 수렴한다는 증명이 붙어 있다 [1]. 실험상으로는 질문 하나에 base 샘플이 1,000개 정도면 reward 이득 추정이 안정됐다. 다만 λ가 작아지면 지수 가중치의 분산이 커져서 수렴에 더 많은 샘플이 들었다 [1]. λ를 0.01에서 10까지 훑으면 KL 예산마다의 최대 reward가 이어져 Pareto frontier가 통째로 그려지고, 이 모든 계산이 학습 이전에 끝난다 [1]. 정책을 한 번도 업데이트하지 않고 상한 곡선을 얻는다는 점이 이 절에서 가장 쓸모 있는 부분이었다.
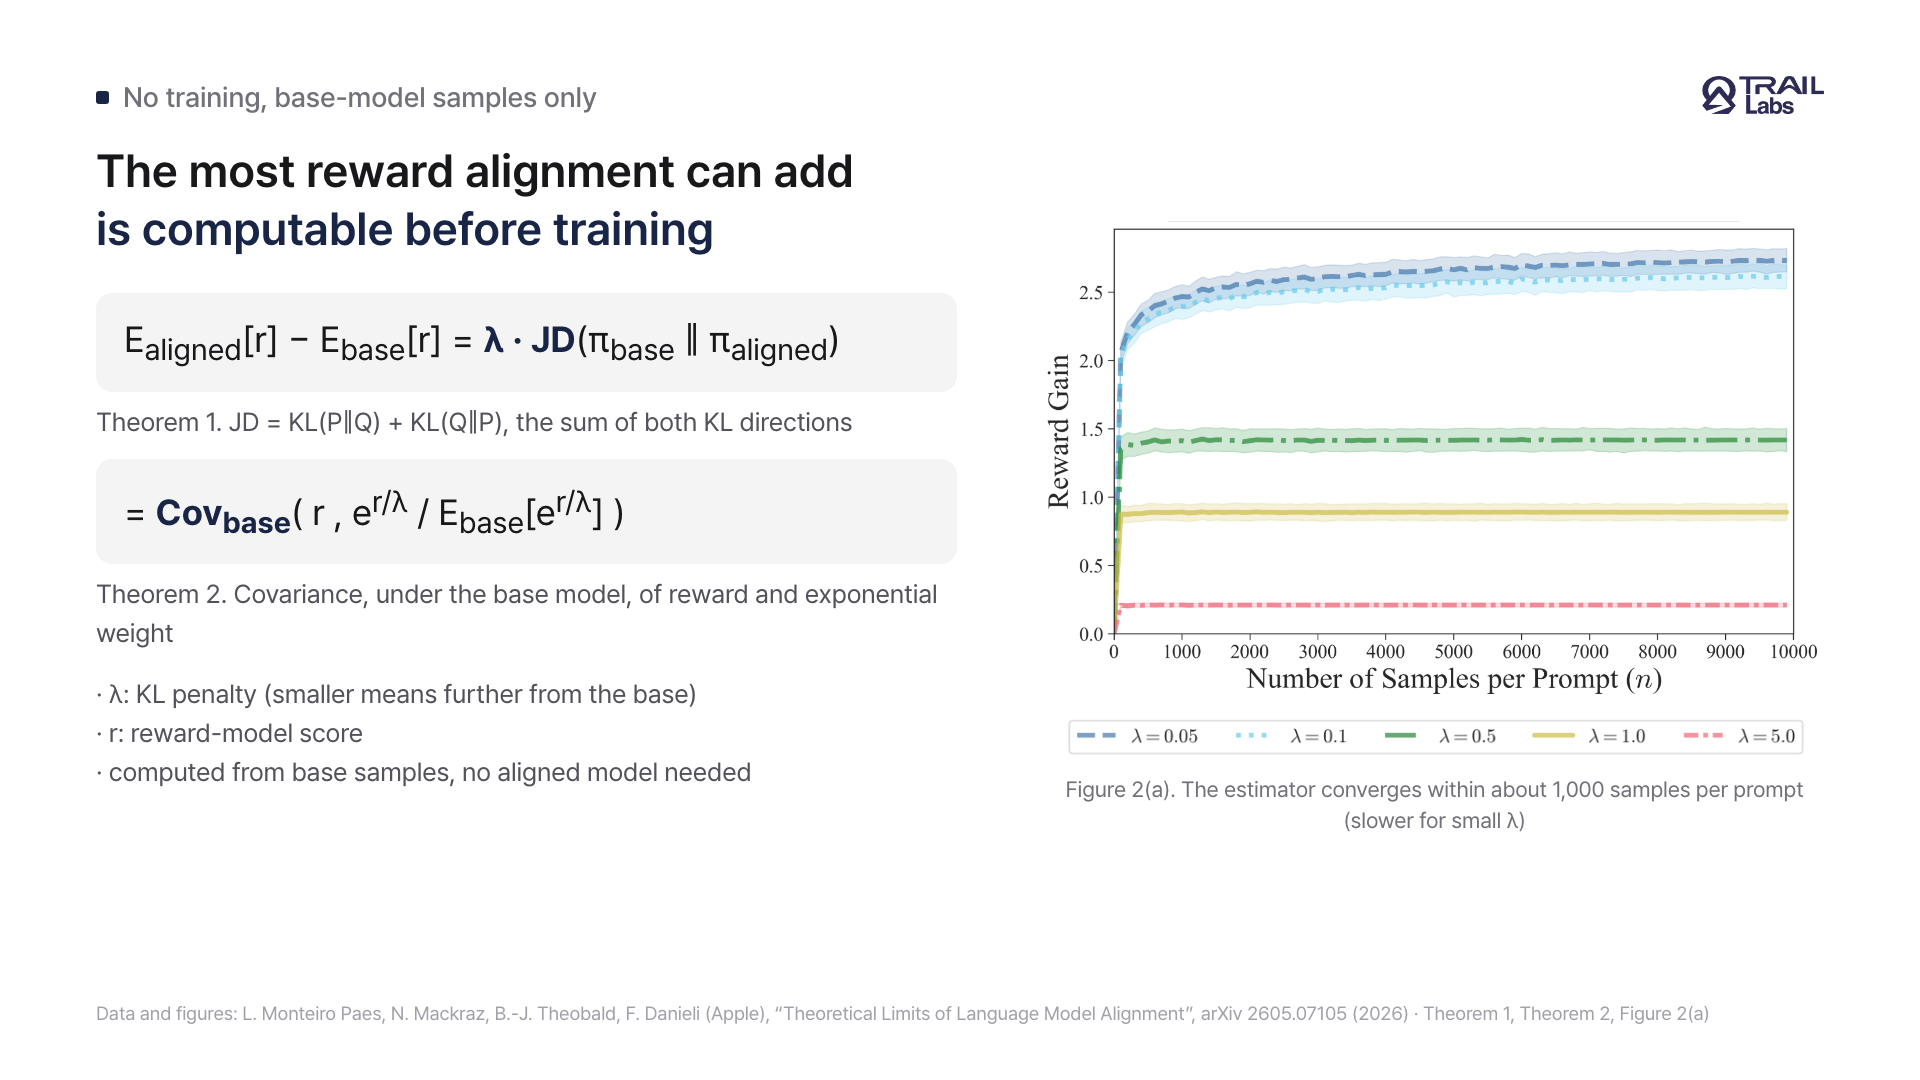
그림 1. 최대 reward 이득은 base 샘플 위 covariance로 학습 없이 구해지고, 샘플을 늘리면 추정값이 안정된다 [1].
PPO와 GRPO는 왜 best-of-N에 못 미치나
결과만 보면 best-of-N은 두 과제에서 천장 곡선과 거의 겹쳤고, PPO와 GRPO는 KL 전 구간에서 곡선 밑에 있었다 [1]. 과제는 safety alignment와 summarization 둘이다. safety 쪽 base는 Zephyr-7B로, Mistral-7B에 UltraChat supervised fine-tuning을 한 모델이다. reward model은 Zephyr-7B를 PKU-SafeRLHF 선호 데이터로 학습시킨 것이다 [1]. summarization 쪽은 Reddit TL;DR로 supervised fine-tuning한 Pythia-1B가 base이고, reward model도 같은 데이터의 선호 쌍으로 학습한 Pythia-1B다 [1]. 비교한 방법은 PPO, GRPO, best-of-N이다. DPO는 reward model을 명시적으로 쓰지 않아서 빠졌다 [1]. PPO와 GRPO는 hyperparameter를 넓게 훑은 뒤 KL 대비 reward가 제일 좋은 실행을 골라 본문에 실었다. best-of-N은 N을 1에서 10,000까지 늘려 가며 돌렸고, KL은 Beirami 등의 추정식으로 구했다 [1][4].
| 과제 | 이론 천장 | Best-of-N | GRPO | PPO |
|---|---|---|---|---|
| 안전 (Zephyr-7B · BeaverTails) | 2.764 | 2.722 | 2.117 | 2.084 |
| 요약 (Pythia-1B · TL;DR) | 0.387 | 0.385 | 0.282 | 0.187 |
표 1. 천장을 계산한 KL 구간(안전은 9.14까지, 요약은 7.96까지)에서 방법별로 얻은 최대 reward 이득 [1]. GRPO와 PPO 값은 본문 그림의 실행에서 가져왔다. 요약 과제 PPO에서 이보다 높게 나온 실행 두 개는 잡음으로 판단돼 빠졌다 [1].
표 1을 천장으로 나눠 보면 best-of-N은 98.5%와 99.5%, GRPO는 76.6%와 72.9%, PPO는 75.4%와 48.3%가 된다 [1]. 저자들은 GRPO와 PPO가 어떤 KL 예산에서도 천장에 못 닿은 점을 지금 RL 기법이 가진 구조적 한계로 해석한다. 그리고 추론 비용을 크게 들이지 않고 최적점에 가려면 알고리즘 쪽 개선이 있어야 한다고 썼다 [1]. 다만 경사 기반 방법이 왜 최적 재가중까지 못 가는지는 논문이 분석하지 않는다. 간극의 크기는 숫자로 나왔지만 그 원인은 아직 빈칸이다.
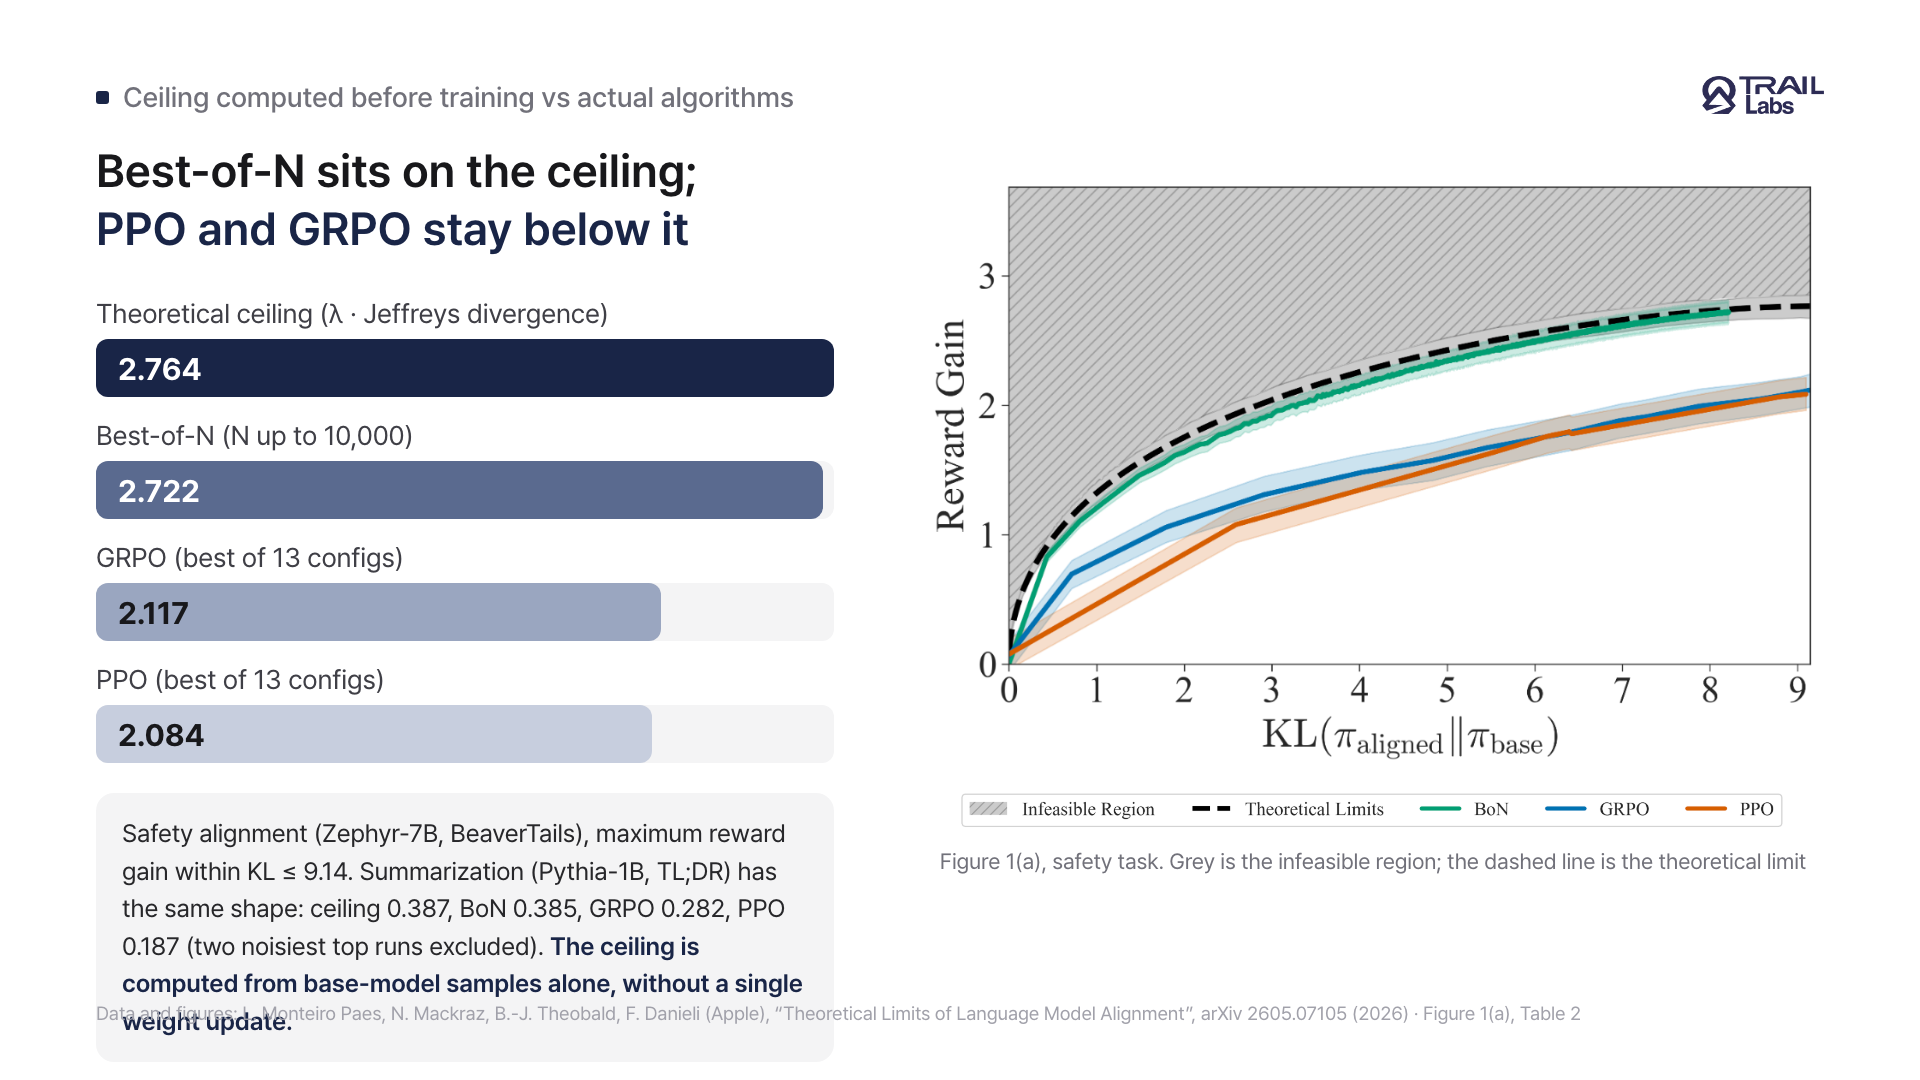
그림 2. safety alignment 결과. 점선 천장에 best-of-N이 붙어 있고, GRPO와 PPO는 KL 전 구간에서 그 밑에 있다 [1].
부록 sweep을 봐도 간극은 줄지 않는다. safety 과제에서 GRPO는 β, learning rate, 생성 수를 바꾼 13개 설정이 최대 reward 이득 1.886에서 2.117 사이로 천장 밑 좁은 띠에 몰렸다. PPO 13개 설정은 0.918에서 2.084로 넓게 퍼졌는데, 그중 천장에 닿은 것은 하나도 없다 [1].
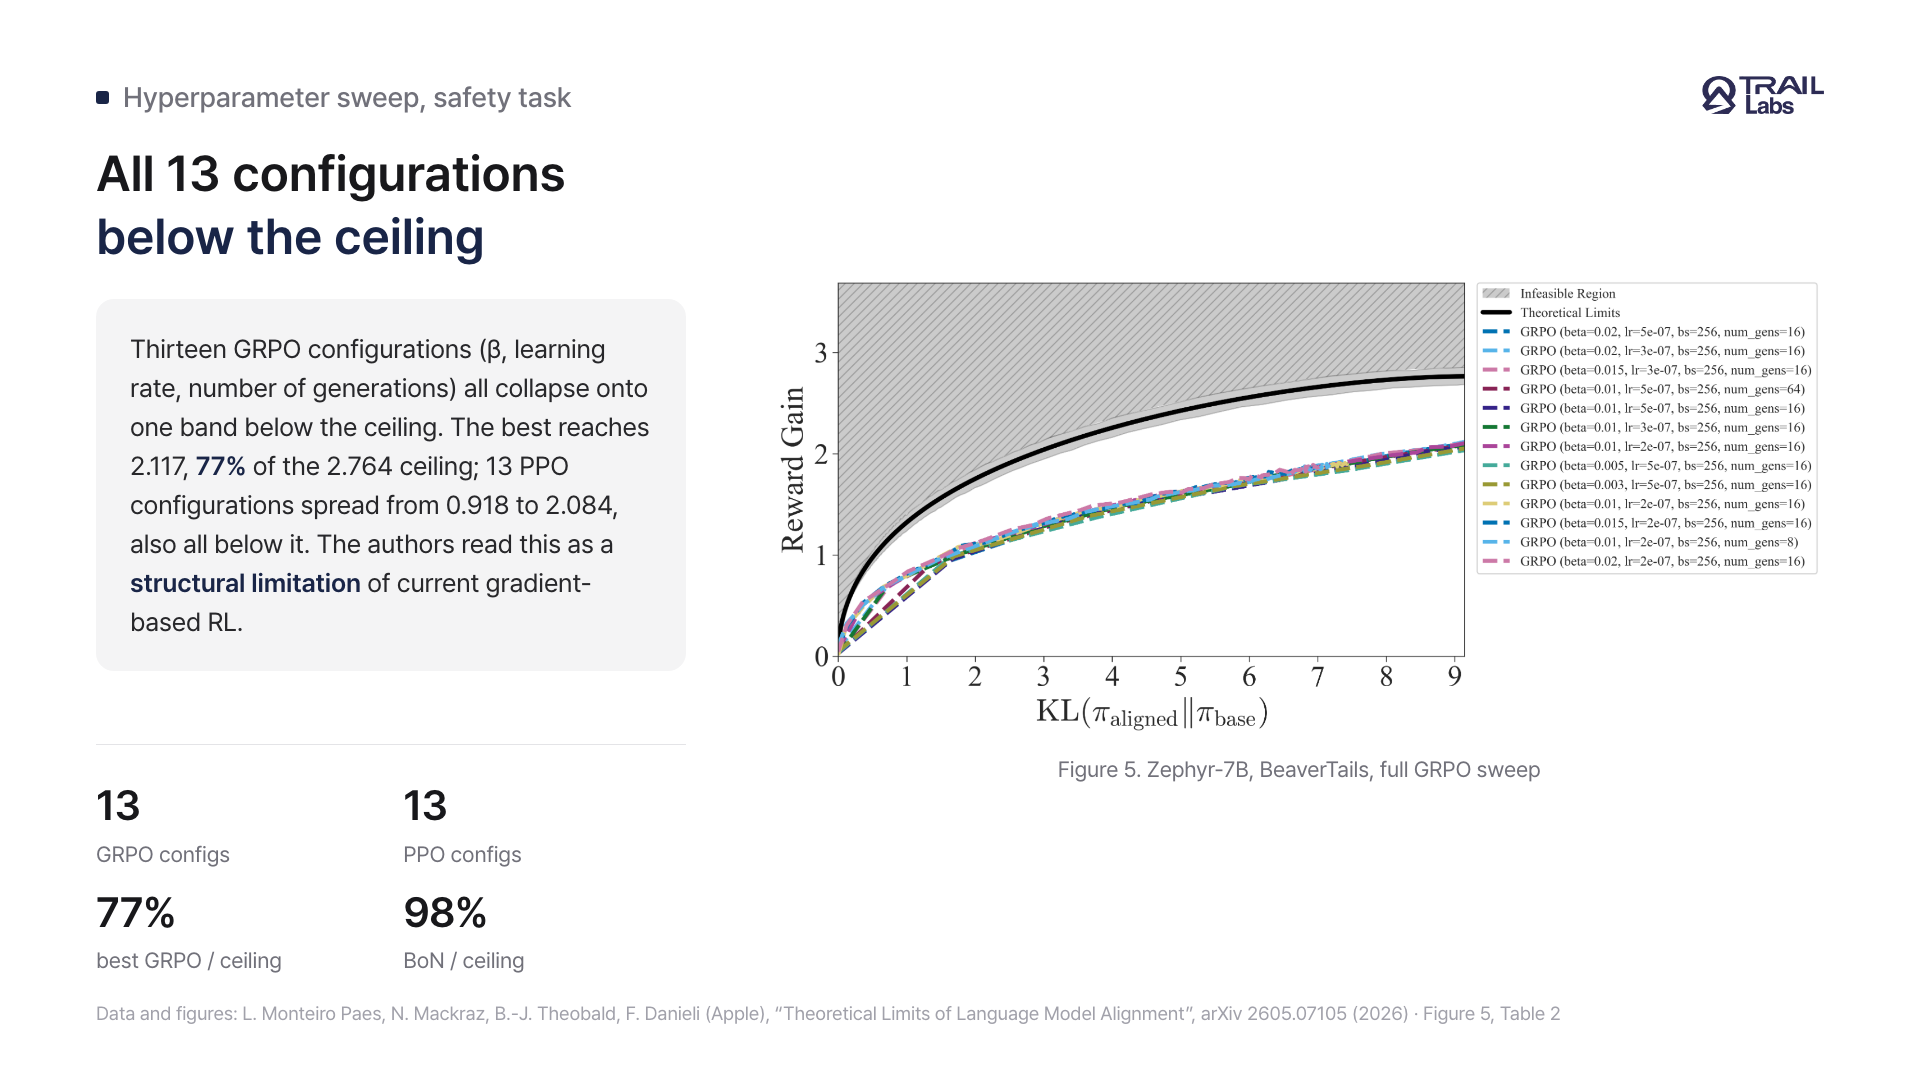
그림 3. GRPO는 어떤 hyperparameter 설정이든 천장 밑 한 띠 안에 들어간다 [1].
reward hacking은 왜 생기고 ensemble은 왜 먹히나
원인은 proxy reward가 가진 오차가 λ로 나뉜 채 지수 함수 안으로 들어간다는 데 있다 [1]. 학습에 실제로 쓰이는 reward model $\tilde r$은 사람 선호를 그대로 담은 이상적 reward $r^$를 흉내 낸 것일 뿐이다. 논문은 그 차이 $N(x,y)=\tilde r(x,y)-r^(x,y)$에 preference residual이라는 이름을 붙인다 [1]. Proposition 3에 따르면, $r^*$로 정렬한 모델과 $\tilde r$로 정렬한 모델이 진짜 reward에서 벌어지는 정도는 covariance 꼴로 쓰이고 그 식 안에 $e^{N(x,y)/\lambda}$가 있다 [1]. λ를 낮춰 base에서 멀어질수록 크기가 같은 오차도 지수로 부풀려진다. Gao 등이 본 overoptimization 곡선이 바로 이 현상으로 설명된다 [1][2].
ensemble이 효과를 내는 이유도 같은 식에서 나온다. Proposition 4는 proxy로 정렬해서 잃는 양을 proxy와 진짜 reward 사이 $L_2$ 거리에 비례하는 Lipschitz형 상한으로 묶는다. Theorem 3은 서로 독립으로 학습한 reward model n개의 평균을 쓰면, 정렬 결과의 진짜 reward가 이상값에 다가가는 속도가 n의 제곱근에 반비례한다는 내용이다 [1]. Coste 등이 실험으로 확인한 ensemble 효과가 여기서 이론으로 뒷받침된다 [5]. 단서가 하나 있는데, reward model 각각이 평균적으로는 진짜 reward와 일치한다는 비편향 가정이 필요하다 [1].
부록 C는 reward model 학습 방식의 문제로까지 내려간다. 요즘 reward model 대부분이 쓰는 Bradley-Terry loss는 두 답 중 어느 쪽이 나은지 순서만 맞추게 할 뿐, 얼마만큼 나은지에는 제약을 걸지 않는다 [1]. 그 결과 loss를 완전히 최소화한 상태에서도 preference residual은 제한 없이 클 수 있다 [1]. 논문의 예시는 유용한 답끼리, 안전한 거절끼리처럼 비교가 그룹 안에서만 일어나는 데이터다. 그룹 간 점수 차이는 loss가 보지 않으니 마음대로 벌어질 수 있고, 이 차이가 Proposition 3의 지수 항을 불린다 [1]. 그래서 저자들은 선호의 순서뿐 아니라 강도까지 학습하는 reward modeling을 제안한다 [1].
내가 RL을 돌린다면 이 결과를 어디에 쓰겠나
여기부터는 내 독해다. 이 논문은 alignment을 분석하는 쪽 이야기지만, 세 가지는 당장 설계에 가져올 만하다.
첫째, 학습을 돌리기 전에 천장을 잰다. 질문마다 base model 답을 1,000개쯤 뽑고 reward를 매겨 두면, KL 예산에 따른 최대 reward가 계산되고 거꾸로 원하는 reward를 얻는 데 KL이 얼마나 필요한지도 보인다 [1]. 천장이 낮게 나오면 나는 알고리즘을 의심하기 전에 base model이나 reward model을 먼저 본다. 거기서 막혀 있으면 PPO를 GRPO로 바꾸든 뭘 하든 상한선은 그대로다.
둘째, 막혔을 때 볼 곳을 좁힌다. 천장 곡선은 base 샘플에서 바로 나오니, 내 학습 결과를 같은 KL 축 위에 올리면 얼마나 모자란지가 한눈에 들어온다 [1]. proxy reward의 잔차 자체는 진짜 reward를 알아야 구할 수 있어 측정이 안 된다. 그래도 λ가 작아질수록 지수로 커진다는 경향과, ensemble로 줄일 수 있다는 처방은 식에 이미 들어 있다 [1].
셋째, best-of-N을 기준선으로 둔다. 실험에서 천장에 붙은 게 best-of-N이었으니, 새 알고리즘은 best-of-N에서 얼마나 떨어져 있는지로 평가하면 충분하다 [1]. 추론 비용을 키우지 않고 최적에 닿는 알고리즘은 저자들도 앞으로의 과제로 남겨 뒀다 [1]. lab에서 한 번 좋은 숫자가 나오는 것과 매일 돌아가는 파이프라인에서 비용까지 맞추는 것의 차이가 늘 이 지점에서 난다.
이 연구의 한계
저자들이 직접 적은 한계가 세 개 있다. 모든 결과가 KL-regularized 목적의 최적해를 전제로 하므로, f-divergence 정규화나 win-rate 최대화, 토큰 단위 KL처럼 목적이 달라지면 그대로 옮겨 쓸 수 없다 [1]. λ가 작은 영역에서는 추정기가 천천히 수렴한다 [1]. reward hacking과 ensemble에 관한 결론은 proxy reward가 평균적으로 치우치지 않는다는 전제 위에 있고, 체계적으로 치우친 경우는 분석 범위 밖이다 [1].
여기에 내가 덧붙이는 것들이 있다. 실험 조합은 Zephyr-7B와 Pythia-1B 두 개, 과제는 단일 턴 두 개가 전부라 다중 턴 에이전트나 코딩 같은 설정은 빠져 있다 [1]. reward 이득을 잰 잣대가 학습에 쓴 그 reward model이므로, 천장에 닿았다고 해서 사람이 보기에 품질이 최고라는 결론으로 이어지지는 않는다. best-of-N의 KL은 실측이 아니라 추정식에서 나온 값이다 [1][4]. PPO와 GRPO 숫자는 저자들 sweep에서 가장 잘 나온 실행이므로, 다른 구현이나 더 큰 모델로 가면 간극이 달라질 여지가 있다. 논문은 arXiv preprint 상태이고 동료심사 여부는 확인하지 못했다. 그래서 나는 이 숫자를 “내 설정에서의 천장”이 아니라 “학습을 돌리기 전에 상한선부터 재라는 방향”으로만 가져간다.
Lucas Monteiro Paes, Natalie Mackraz, Barry-John Theobald, Federico Danieli (Apple), “Theoretical Limits of Language Model Alignment”, arXiv 2605.07105 (2026).
References
- Lucas Monteiro Paes, Natalie Mackraz, Barry-John Theobald, Federico Danieli (Apple), “Theoretical Limits of Language Model Alignment”, arXiv 2026
- Leo Gao, John Schulman, Jacob Hilton, “Scaling Laws for Reward Model Overoptimization”, ICML 2023
- Youssef Mroueh, Apoorva Nitsure, “Information Theoretic Guarantees for Policy Alignment in Large Language Models”, TMLR 2025
- Ahmad Beirami et al., “Theoretical Guarantees on the Best-of-n Alignment Policy”, ICML 2025
- Thomas Coste, Usman Anwar, Robert Kirk, David Krueger, “Reward Model Ensembles Help Mitigate Overoptimization”, ICLR 2024