



긴 영상을 모델에 먹일 때 제일 먼저 떠오르는 손잡이는 frame 샘플 수를 키우는 것인데, 이게 점수를 꼭 올려 주지는 않는다. Video-RAG가 택한 길은 다르다. 화면 속 글자, 음성, 물체를 텍스트로 바꾸고 질문과 관련된 조각만 retrieval 해서 입력에 덧붙인다. 추가 학습 없이 72B 모델의 Video-MME 점수(자막 포함 기준)가 75.9에서 77.4가 됐다 [1]. 논문은 NeurIPS 2025 본 학회에 실렸고, Xiamen University와 University of Rochester를 비롯한 여러 기관이 함께 썼다 [1].
긴 media를 모델에 붙여본 사람이면 겪는 장면이 있다. context 한계에 부딪히면 “frame을 더 샘플링하자”가 반사적으로 나온다. 그런데 비용은 오르는데 점수는 안 오르거나 오히려 떨어진다. 내가 model compression 쪽에서 오래 본 문제와 같은 모양이다. 입력을 무작정 늘리는 게 아니라, 필요한 정보만 싼 표현으로 바꾸는 것. 이 논문이 좋았던 건 그 교체를 숫자로 보여줬다는 점이다. 2026년 10월에 arXiv 원문을 펴 놓고 본문, 그림 2, 표 1–5의 숫자를 원문과 맞춰 가며 적은 메모다. GitHub에 code가 올라와 있으나 내 손으로 재현하지는 않았다. 저자들과 아무 관계도 없다.
왜 frame을 늘리면 안 되나
대부분의 영상 이해 모델은 영상을 고정 간격으로 끊어 frame 묶음을 입력으로 받는다. 직관적으로는 frame이 많을수록 담기는 정보도 많을 것 같다. 논문은 여기에 두 가지 반론을 낸다 [1]. 비슷한 장면이 계속 들어가면서 같은 정보가 겹친다는 것, 그리고 어느 개수를 지나면 성능이 도리어 내려간다는 것이다. 예로 든 LongVA는 Video-MME에서 frame을 128개에서 384개로 늘리자 52.6%가 51.8%로 내려갔다 [1][2].
기존에 긴 영상을 처리하던 접근은 크게 둘로 나뉜다. 첫째는 긴 context를 받도록 모델을 재학습하는 쪽이고, 데이터와 GPU가 대량으로 든다. 둘째는 GPT-4o 같은 상용 모델을 agent로 부리는 쪽이다. 논문 계산으로는 VideoAgent로 Video-MME 하나를 끝까지 돌리는 데 20일 남짓과 API 비용 2,000달러 정도가 들어간다 [1][3]. 결국 두 방향 모두 입력을 더 밀어 넣거나 엔진을 키우는 쪽이다.
Video-RAG는 뭘 하나
핵심 아이디어는 frame을 추가해서 생길 visual token 자리를 영상에서 추출한 보조 텍스트로 채우는 것이다 [1]. 파이프라인은 세 단계다(그림 2) [1].
1단계, query decoupling. 이 단계에서 모델은 frame을 보지 않는다. 질문만 읽고 무엇이 필요할지 JSON 형식의 retrieval 요청으로 적는다. 요청 종류는 음성(R_asr), 물체(R_det), 물체의 위치·개수·관계(R_type) 셋이다 [1].
2단계, 보조 텍스트 생성과 retrieval. 영상 하나에서 데이터베이스 세 개를 동시에 구축한다 [1].
- OCR: frame마다 EasyOCR을 돌려 화면에 찍힌 글자를 뽑는다. 뽑은 조각은 Contriever[4] embedding으로 FAISS에 색인하고, 질문과 similarity 0.3 초과인 것만 꺼낸다.
- ASR: 음성은 Whisper로 받아 적고 chunk 단위로 자른 다음, OCR 쪽과 똑같이 색인한다.
- 객체 검출: 우선 질문 속 물체 요청과 CLIP similarity가 0.3보다 큰 keyframe만 남기고, 거기에 APE를 돌려 물체를 찾는다. 검출 결과는 위치, 개수, 서로 간 관계를 서술한 scene-graph 문장으로 옮긴다.
3단계, 통합 생성. 꺼내 온 텍스트를 시간 순서대로 늘어놓고 질문과 이어 붙인 뒤 frame 입력 옆에 넣는다. 수식으로는 아래와 같다 [1].
\[O = \mathrm{LVLM}\big(F_v,\; \mathrm{Concat}(A_m, Q)\big)\]$F_v$는 샘플링된 frame에서 얻은 visual feature, $A_m$은 retrieval로 모은 보조 텍스트, $Q$는 질문, $O$는 출력 답이다. 보조 텍스트 길이는 평균 2.0K token 정도로, 한 영상의 자막을 통째로 넣을 때(3.0K token 정도)보다 적다 [1].
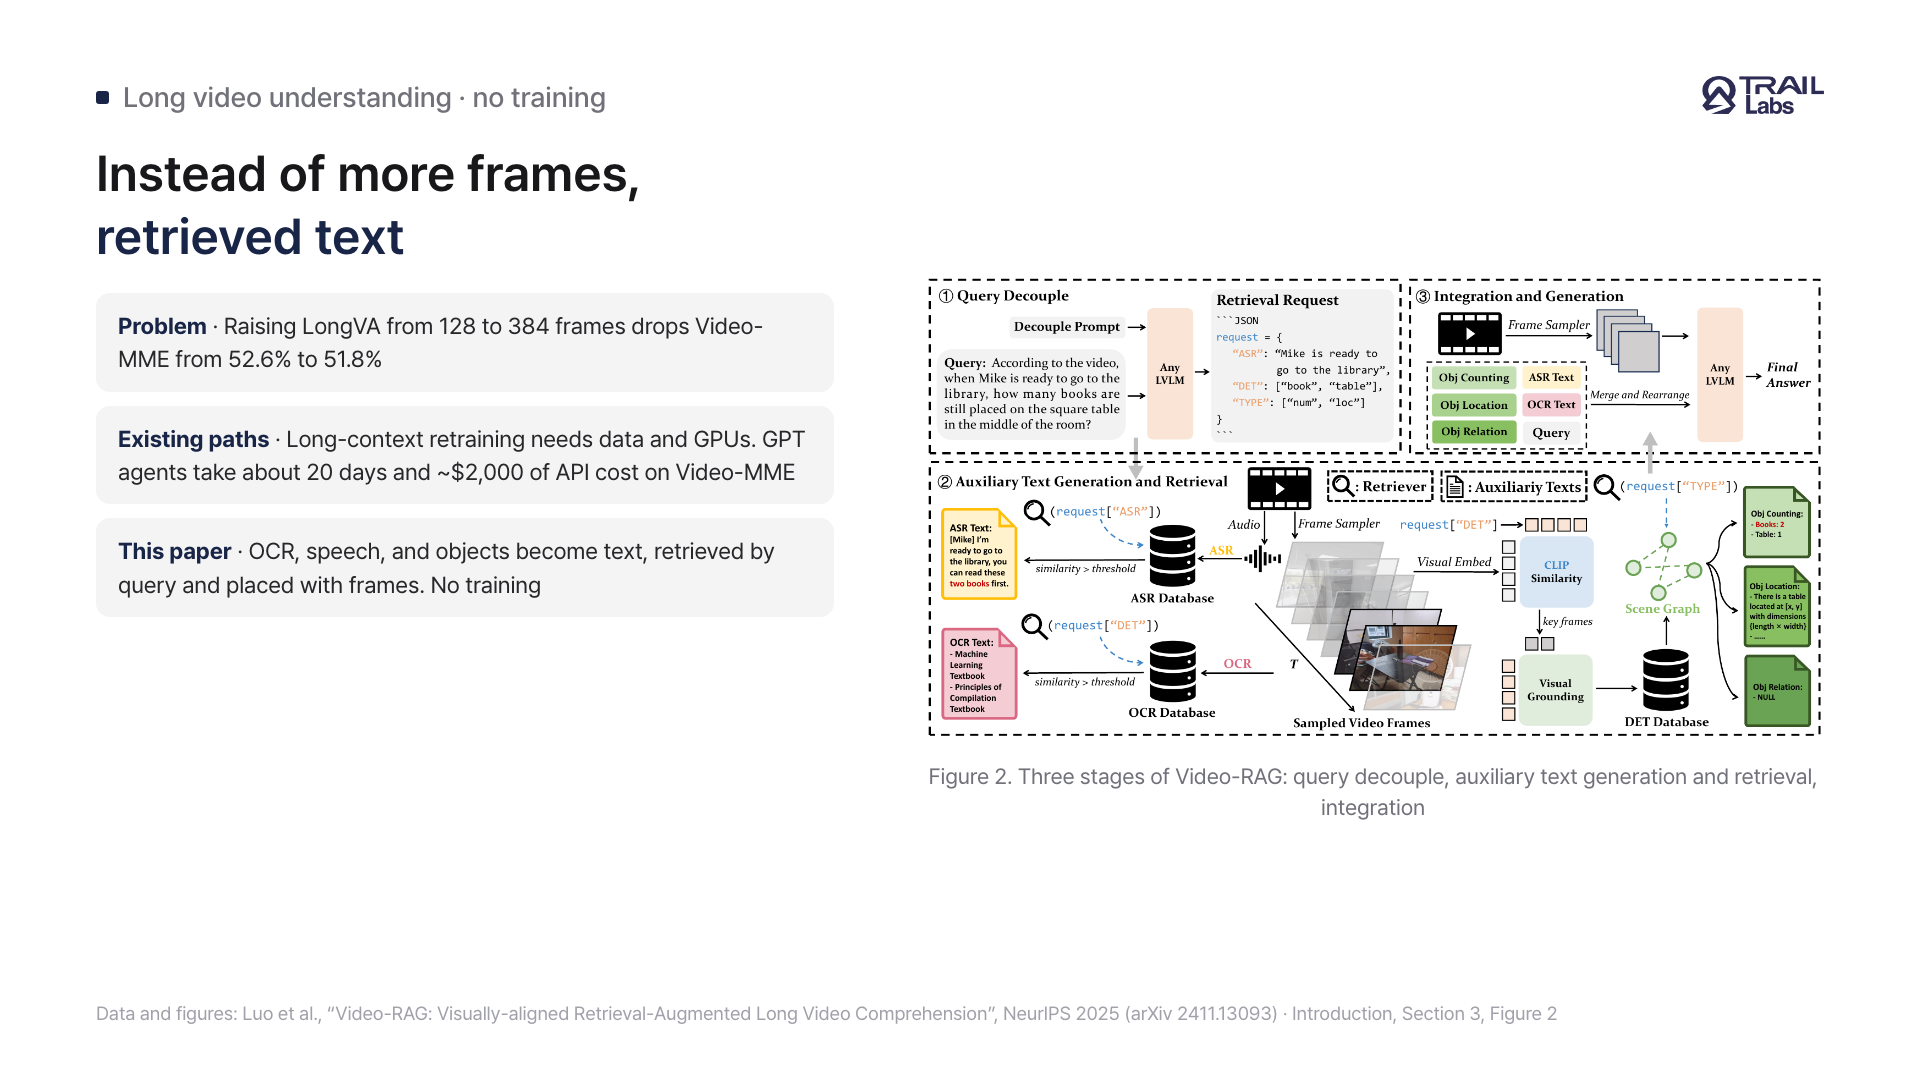
그림 1. Video-RAG 파이프라인. query decoupling을 거쳐 보조 텍스트를 만들고 retrieval 한 뒤, 마지막에 한꺼번에 생성한다 [1].
실험은 어떻게 했나
Video-MME에는 공개 영상-언어 모델 7개를 올렸다. 7B급이 다섯, 72B급이 둘이다. MLVU와 LongVideoBench는 LLaVA-Video 7B와 72B 두 개로만 돌렸다 [1]. 오픈 모델 숫자는 저자들이 다시 돌려 얻은 값이고, GPT-4o와 Gemini 숫자는 다른 문헌에서 가져왔다 [1]. frame 개수는 모델별 공식 설정 그대로 썼고, 장비는 A100 80GB GPU였다. threshold 두 개는 둘 다 0.3에 고정했다 [1].
부록을 보면 query decoupling prompt는 처음부터 객관식 질문용으로 만들어졌다. 본문 평가에 쓴 벤치마크 세 개도 전부 객관식이다 [1].
결과는 얼마나 나왔나
Video-MME에서 일곱 모델을 평균하면, 자막을 넣은 기준선보다 2.8점이 높았다. 제일 큰 72B LLaVA-Video는 자막 포함 75.9가 77.4로 올랐는데, 이는 자막을 넣은 GPT-4o 77.2보다 0.2점 높은 값이다 [1].
| 벤치마크 · 모델 | 기준 | Video-RAG | 비교 (상용 모델, 논문 인용) |
|---|---|---|---|
| Video-MME · 72B LLaVA-Video | 75.9 (자막 포함) | 77.4 | GPT-4o 77.2, Gemini-1.5-Pro 81.3 (자막 포함) |
| LongVideoBench · 72B LLaVA-Video | 61.9 | 65.4 | GPT-4o 66.7, Gemini-1.5-Pro 64.0 |
| MLVU · 72B LLaVA-Video | 73.1 | 73.8 | GPT-4o 64.6 |
| LongVideoBench · 7B LLaVA-Video | 56.6 | 58.7 | - |
표 1. 출처는 논문 표 1, 2, 3이다 [1]. 상용 모델 숫자는 논문이 다른 문헌에서 인용했다.
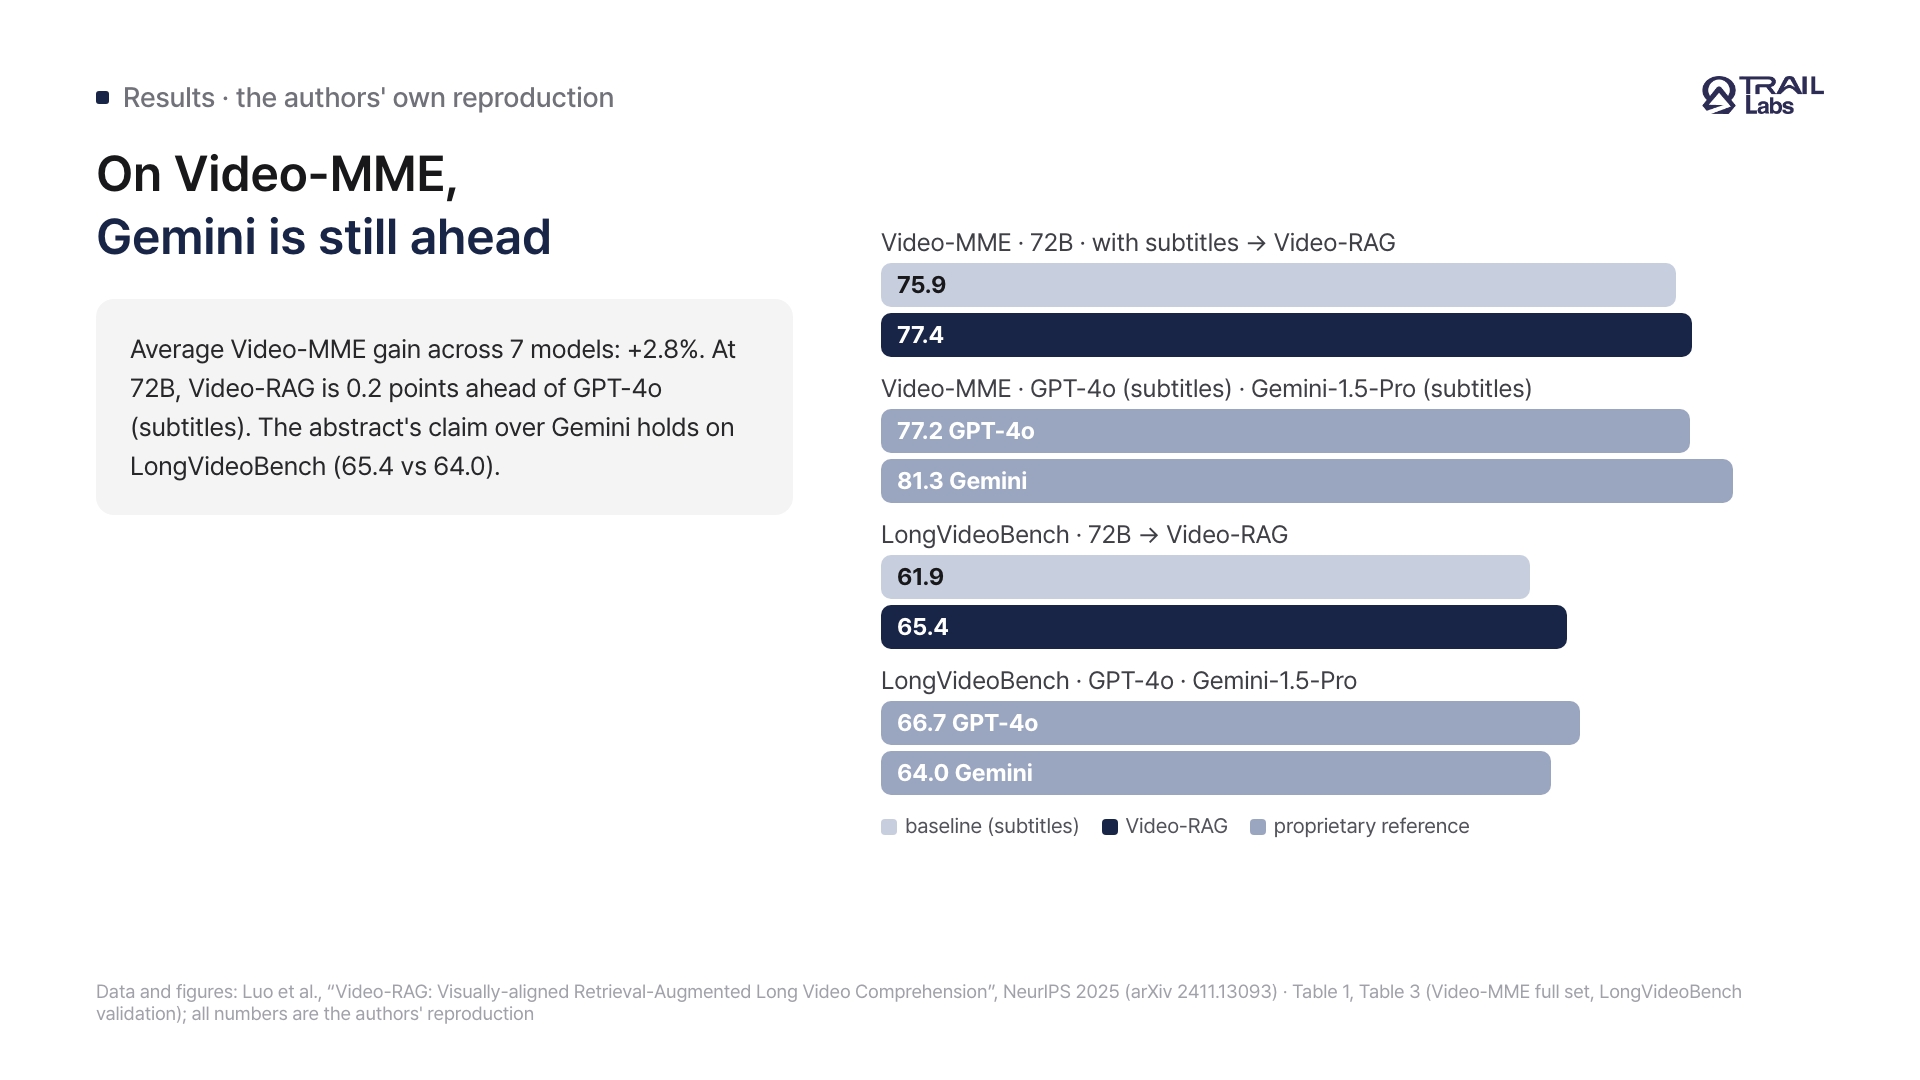
그림 2. 72B 모델 기준선과 Video-RAG 비교. 상용 모델 숫자는 논문의 인용값이다 [1].
초록에는 72B 모델이 Gemini-1.5-Pro를 넘었다고 나온다. 표를 보면 Video-MME에서는 사정이 다르다. Gemini의 자막 포함 점수 81.3이 Video-RAG 77.4보다 위다. 넘어선 곳은 LongVideoBench이고 65.4 대 64.0이다. 그 LongVideoBench에서도 GPT-4o의 66.7에는 닿지 못했다 [1]. 그래서 나는 벤치마크마다 기준을 나누어 읽는다. 한 숫자로 “앞섰다”를 가져가면 어디서 앞섰는지가 뭉개진다.
OCR·speech 텍스트는 성능을 얼마나 올리나
구성 요소별 기여는 Long-LLaVA 7B, 32 frame, Video-MME 조합으로 쟀다 [1]. 보조 텍스트를 하나도 안 넣으면 52.0이다. 세 종류 텍스트를 retrieval 없이 모두 넣으면 59.8로 오르고, retrieval로 걸러 넣으면 62.1까지 간다. retrieval 단계만의 몫이 2.3점인 셈이다. 저자들은 음성 텍스트까지 포함해 고르게 개선됐고, 길이가 긴 영상일수록 효과가 컸다고 설명한다 [1].
retrieval 기준을 얼마나 빡빡하게 잡느냐는 threshold 실험에서 드러난다.
| threshold t | 보조 텍스트 token | 점수 |
|---|---|---|
| 0.0 | 3.6K | 62.0 |
| 0.3 | 1.9K | 62.1 |
| 0.5 | 0.3K | 56.1 |
| 1.0 (텍스트 없음) | 0 | 52.0 |
표 2. 출처는 논문 표 5다 [1]. 0.3과 0.0은 점수로는 0.1점밖에 차이 나지 않는다. 대신 token이 3.6K에서 1.9K로, 질의 하나에 걸리는 시간이 36초에서 11초로 떨어진다.
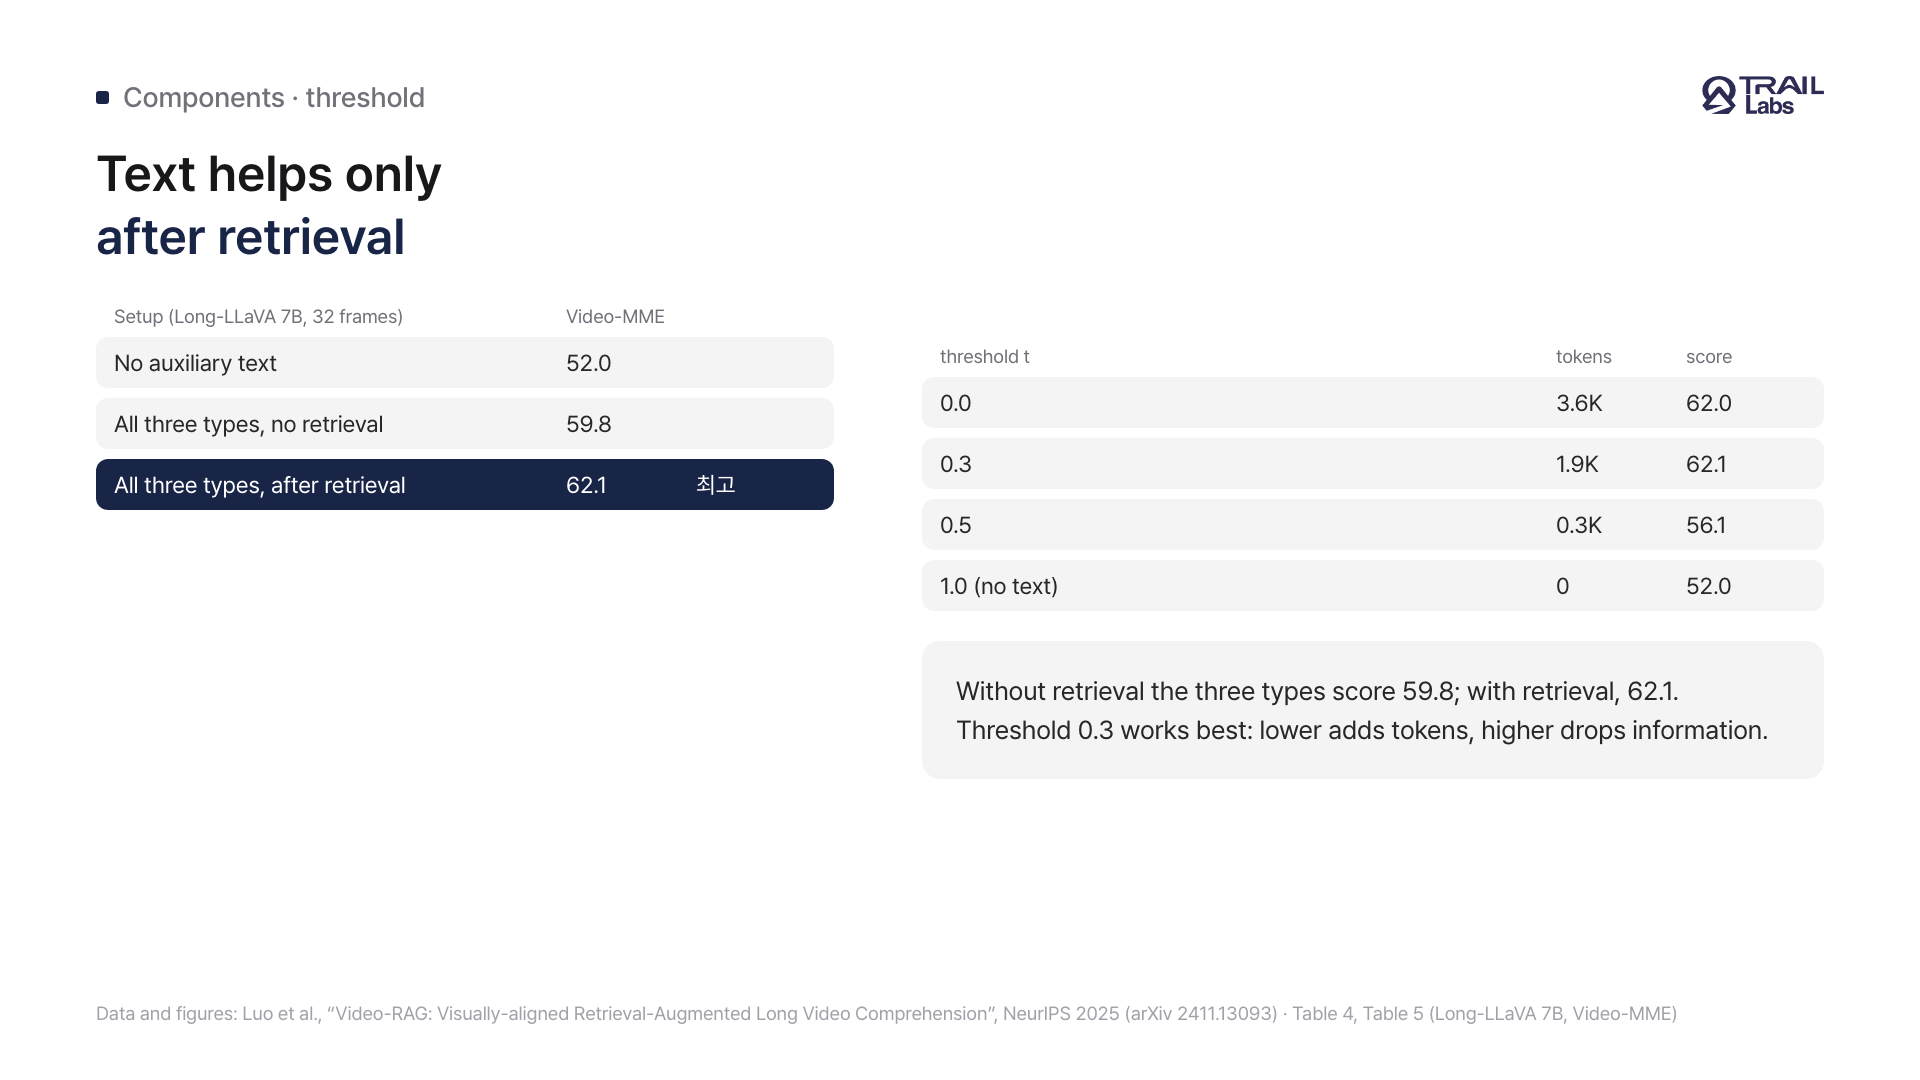
그림 3. retrieval로 거른 텍스트가 거르지 않고 넣은 텍스트보다 높은 점수를 냈고, threshold는 0.3일 때 제일 좋았다 [1].
비용 숫자도 있다. 7B 모델 앞에 붙이면 GPU 메모리가 8GB가량, 질의마다 시간이 5초가량 더 든다. 덧붙는 보조 텍스트 2.0K token 정도는 frame으로 치면 14장 안팎이다 [1].
내가 붙인다면 뭘 보겠나
여기부터는 내 독해다. 이 논문은 영상 모델 쪽 이야기지만, 입력을 싼 표현으로 바꾸는 쪽에서 일해 온 입장에서 세 가지가 눈에 남는다.
첫째, 나라면 비용부터 본다. 내가 뽑는 헤드라인은 Video-MME +1.5점이 아니다. frame을 더 넣지 않고 retrieval token 2.0K 정도만으로 같거나 더 나은 점수를 냈다는 쪽이다. threshold를 0.0에서 0.3으로 올리면 점수는 0.1점만 달라지는데 token은 반으로, 질의 시간은 36초에서 11초로 줄어든다. compute budget이 빠듯한 환경이라면 이 교체가 정확도 0.1점보다 큰 레버다. 입력을 늘리는 대신 필요한 정보만 싸게 표현하는 선택은 model compression에서 늘 하던 일이다.
둘째, 학습 없이 앞에 붙는다는 점이 이걸 제품에 닿게 한다. lab에서 되는 것 대부분은 재학습·데이터·GPU·운영이 붙으면서 현실 파이프라인까지 못 간다. Video-RAG는 이미 돌리는 모델 앞에 retrieval 레이어만 얹는 구조라, 엔진 교체 비용 없이 내 스택에 들어온다. 그래서 나라면 더 센 모델로 갈아끼우기 전에 이 레이어부터 시험한다.
셋째, stream을 하나로 켜지 않는다. 보이는 걸 텍스트로 바꾸는 건 공짜가 아니다. 부록 VNBench에서는 음성 텍스트를 넣었더니 42.8이 42.5로 내려갔다. query decoupling은 frame 없이 질문만 보고 물체를 정하니, 질문이 언급하지 않은 물체는 빠진다. 그래서 OCR·ASR·검출을 한 덩어리로 켜지 말고 stream별로 끄고 켜며 과제마다 측정한다. 매일 돌아가는 것과 한 번 맞히는 것의 차이는 늘 이 지점에서 난다.
이 연구의 한계
논문 쪽 사정부터 적는다. 한계만 따로 모아 둔 절은 없다. 본문 평가는 세 개의 객관식 벤치마크로 한정되고, 부록에 나오는 VNBench는 합성 데이터 과제다. 그 부록 실험에서 객체 텍스트와 OCR 텍스트는 retrieval 성능에 보탬이 됐지만, 음성 텍스트를 넣었을 때는 42.8에서 42.5로 떨어졌다 [1].
내 쪽에서 본 약점은 세 가지다. 하나, query decoupling이 frame을 안 보고 질문 문장에만 기대어 물체를 정하니, 질문에 이름이 안 나온 물체는 검출 대상에서 빠지기 쉽다. 둘, OCR이나 ASR, 검출기가 틀리면 그 틀린 텍스트가 걸러지지 않고 모델로 들어간다. 이 오류가 어떻게 번지는지는 논문이 들여다보지 않았다. 셋, 오픈 모델 점수는 저자들이 다시 돌린 값이고 사람이 직접 평가한 결과는 없다. 서술형 영상 QA에서도 효과가 유지되는지는 별도로 봐야 한다. 그래서 나는 이 숫자를 “내 설정에서의 상한선”이 아니라 “frame을 늘리기 전에 텍스트 retrieval을 먼저 재 보라는 방향”으로만 가져간다.
Yongdong Luo, Xiawu Zheng, Guilin Li, Shukang Yin, Haojia Lin, Chaoyou Fu, Jinfa Huang, Jiayi Ji, Fei Chao, Jiebo Luo, Rongrong Ji, “Video-RAG: Visually-aligned Retrieval-Augmented Long Video Comprehension”, NeurIPS 2025 (arXiv 2411.13093).
References
- Yongdong Luo, Xiawu Zheng et al., “Video-RAG: Visually-aligned Retrieval-Augmented Long Video Comprehension”, NeurIPS 2025 (arXiv 2411.13093)
- Chaoyou Fu et al., “Video-MME: The First-Ever Comprehensive Evaluation Benchmark of Multi-modal LLMs in Video Analysis”, 2024
- Yue Fan et al., “VideoAgent: A Memory-augmented Multimodal Agent for Video Understanding”, ECCV 2024 (arXiv 2403.11481)
- Gautier Izacard et al., “Unsupervised Dense Information Retrieval with Contrastive Learning” (Contriever), 2021