



retrieval이 완벽하다고 가정하고 근거 후보를 손에 쥐여 줘도, 표와 그림이 섞인 긴 문서에서 가장 잘한 모델의 quote selection F1은 70.2%였다. 후보 20개 가운데 실제 근거는 중앙값 기준 2개밖에 없고, 텍스트 근거(52.0)를 고르는 쪽이 이미지 근거(80.7)보다 더 틀렸다 [1]. 이 벤치마크 MMDocRAG는 Huawei Noah’s Ark Lab 팀이 만들었고 NeurIPS 2025 Datasets & Benchmarks 트랙에 실렸다 [1].
문서를 retrieval 파이프라인에 넣어본 사람이면 겪는 장면이 있다. 재무 표나 차트에 답이 들어 있는데, 그 페이지를 가져와도 모델이 엉뚱한 문단을 근거로 집는다. 답이 맞았는지만 보면 이게 retrieval 문제인지 selection 문제인지 구분이 안 된다. 이 벤치마크가 좋았던 건 “근거를 찾아 넣는 것”과 “넣어준 근거 중에서 고르는 것”을 떼어내서 각각 숫자로 보여줬다는 점이다. 2026년 10월에 arXiv 원문과 NeurIPS 카메라레디판을 읽으면서 Table 1·2·3·5·6, Figure 8의 숫자를 맞춰 본 기록이다. 데이터와 코드는 프로젝트 페이지에서 받을 수 있지만 [2] 나는 돌려 보지 않았다. 저자들과 연결된 것은 없다.
벤치마크는 무엇을 재나
회사에서 다루는 문서에는 본문 말고도 재무 표, 차트, 다이어그램이 끼어 있다. 질문 하나에 대한 답이 여러 페이지, 여러 형식에 나뉘어 있는 일도 흔하다. MMDocRAG가 모델에게 맡기는 일은 둘이다. 하나는 quote selection으로, 질문과 관련된 근거 조각을 골라내는 것이다. 다른 하나는 multimodal generation으로, 골라낸 조각을 이용해 글과 이미지가 섞인 답을 써내는 것이다 [1].
QA는 전문가가 직접 주석한 4,055개다. 2,055개는 개발용, 2,000개는 평가용이다. 출처 문서는 222개이고 10개 유형에 걸쳐 있으며, 한 문서가 평균 67쪽, 33,000단어 남짓이다 [1].
채점 방식에서 눈여겨볼 부분은 후보를 구성하는 법이다. 질문마다 후보 조각이 15개나 20개 붙는데, 그중 gold 조각은 중앙값 2개(평균 2.7)에 불과하다. 나머지 자리는 hard negative가 채운다. hard negative란 질문이나 답과 글자, 그림 생김새가 닮아서 헷갈리게 만드는 가짜 근거이고, retrieval 상위 결과에서 가져왔다. 덕분에 후보 더미에서 진짜만 골라내는 능력을 F1 하나로 측정할 수 있다 [1].
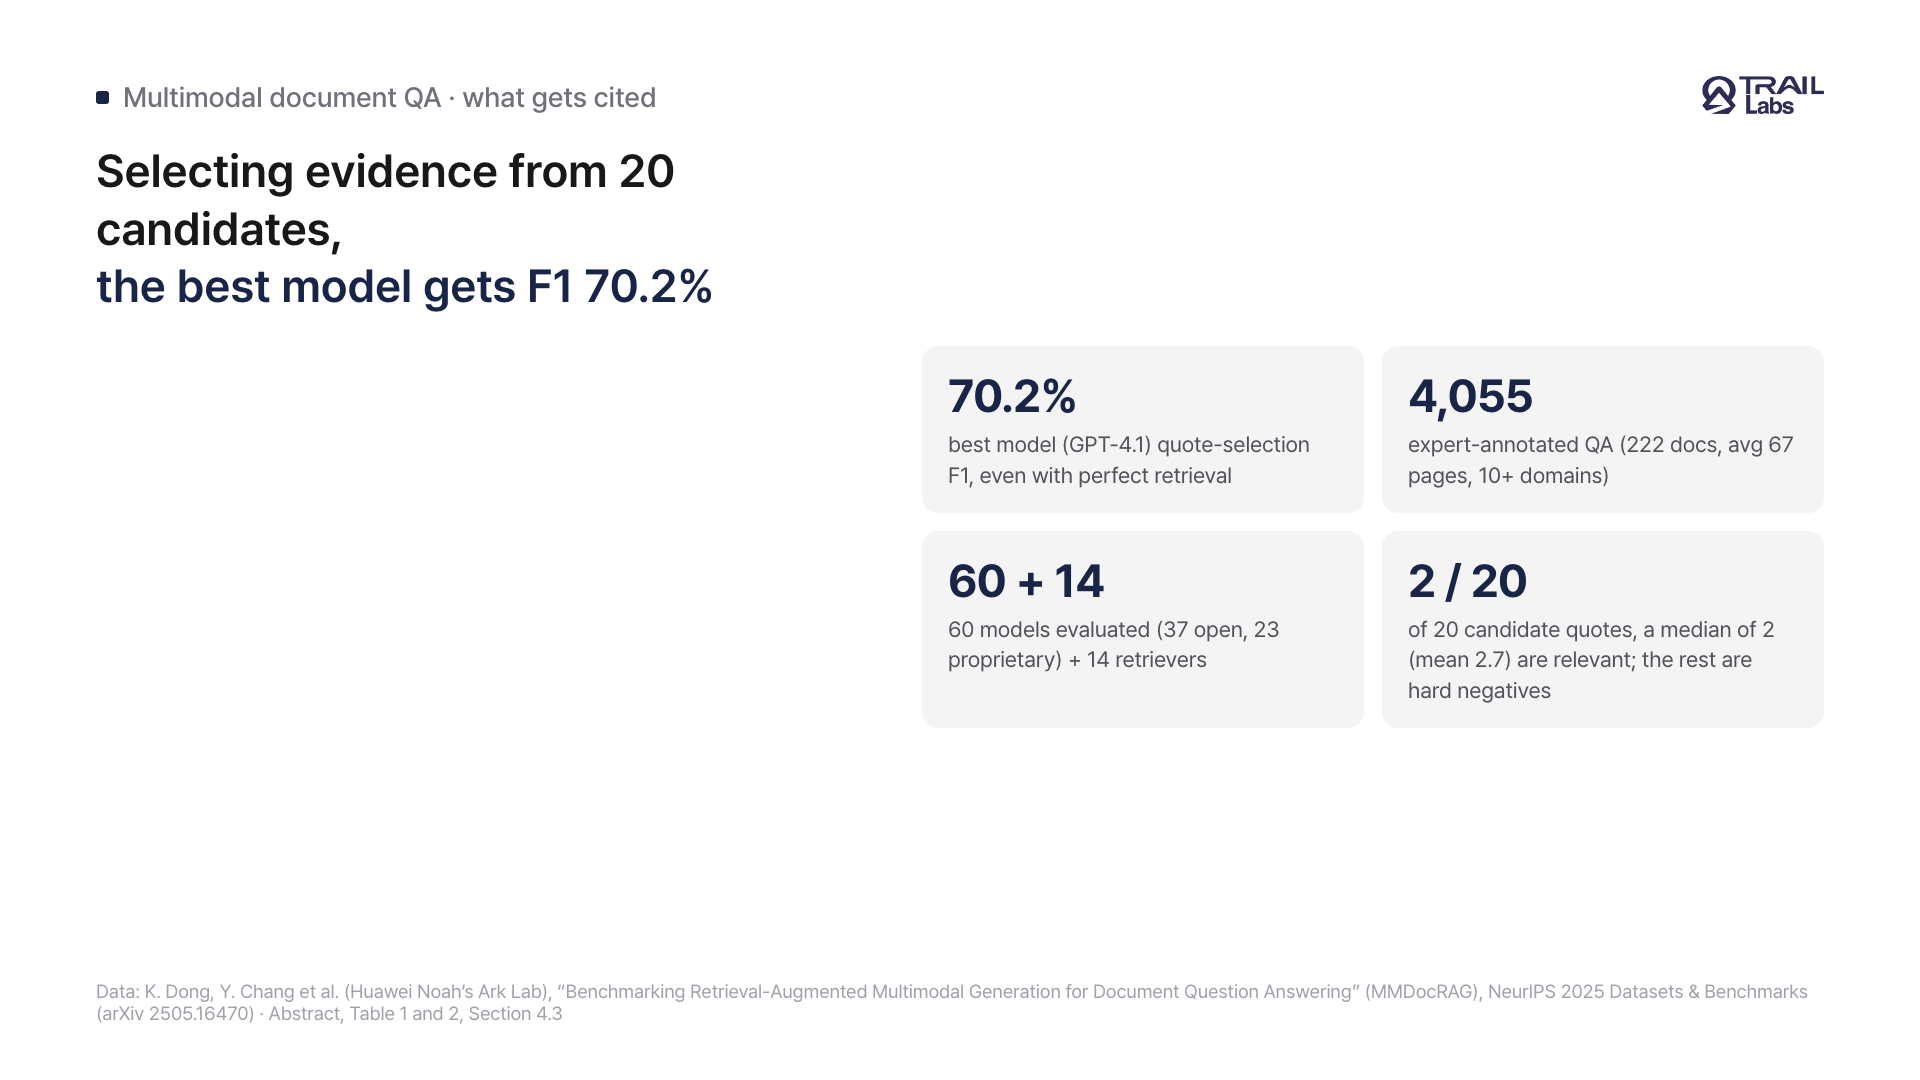
그림 1. MMDocRAG 과제 구성과 크기. 후보 20개에서 근거를 골라야 하고, retrieval을 완벽하다고 쳐도 1위 모델 F1은 70.2%다 [1].
완벽 retrieval을 줘도 선택이 어렵다
retrieval 오류를 아예 배제하려고, 이 실험은 gold가 반드시 들어 있는 후보 묶음을 고정해서 주고 고르는 능력만 본다. 그렇게 조건을 유리하게 만들어도 1위인 GPT-4.1의 selection F1은 70.2%였다. 논문도 최신 모델이 이 선에서 멈춘다는 점을 짚는다 [1].
근거 형식에 따라 격차가 컸다. GPT-4.1 기준으로 텍스트 조각 F1은 52.0, 이미지 조각 F1은 80.7이다. 그림 근거는 꽤 잘 찾는데 글 근거에서 더 많이 헤맸다는 뜻이다. 답 자체의 품질은 유창성, citation 품질, 글과 이미지의 일관성, 추론, 사실성 다섯 항목으로 나눠 매겼고, 5점 만점에 평균 4.14점으로 GPT-4.1이 가장 높았다 [1].
상용과 공개 모델 사이 간격도 뚜렷했다. 논문 정리로는 상용 VLM이 공개 VLM과 LLM 모두를 큰 폭으로 앞섰다. 공개 모델, 특히 작은 모델에게는 multimodal 입력이 도움보다 방해가 됐다. 크기가 같은 경우 LLM이 VLM보다 selection F1이 높게 나왔고, Qwen 계열에서 그 차이가 7B는 175.9%, 32B는 62.7%였다. 모델이 작을수록 길게 이어지는 multimodal 입력을 감당하지 못한다고 읽힌다 [1].
진짜 병목은 retrieval이었다
앞 절의 숫자는 모두 gold를 넣어 준 완벽 retrieval 조건이다. 현실에서는 retriever가 먼저 후보를 모아 와야 하고, 여기서 손실이 크게 났다. GPT-4.1로 처음부터 끝까지 돌리면, 완벽 retrieval에서 70.2였던 selection F1이 기본 retriever BGE로 바꾸는 순간 54.4가 된다. 질문을 여러 절로 늘리고 BGE, Qwen3-0.6B, BM25, E5 네 retriever를 합쳐 recall을 84.9%까지 끌어올려도 F1은 59.9에서 멈췄다 [1].
| retrieval 조건 | 조각 retrieval recall | quote selection F1 | 답 품질(5점) |
|---|---|---|---|
| 완벽 retrieval (oracle) | - | 70.2 | 4.14 |
| 기본 retriever (BGE) | 71.0 | 54.4 | 3.53 |
| retriever 4종 ensemble + query expansion | 84.9 | 59.9 | 3.79 |
표 1. 출처는 논문 Table 6(GPT-4.1, 후보 20개)이다. recall을 85% 가까이 되살려도 selection F1과 답 품질은 oracle 조건까지 올라가지 못했다 [1].
형식에 따라 retrieval이 얼마나 어려운지도 달랐다. 텍스트 조각 recall은 설정별로 34.6–49.5%에 그친 반면, 이미지 조각은 77.8–86.8%로 한참 위였다. 글 근거는 찾는 단계에서도, 고르는 단계에서도 더 까다로웠다 [1].
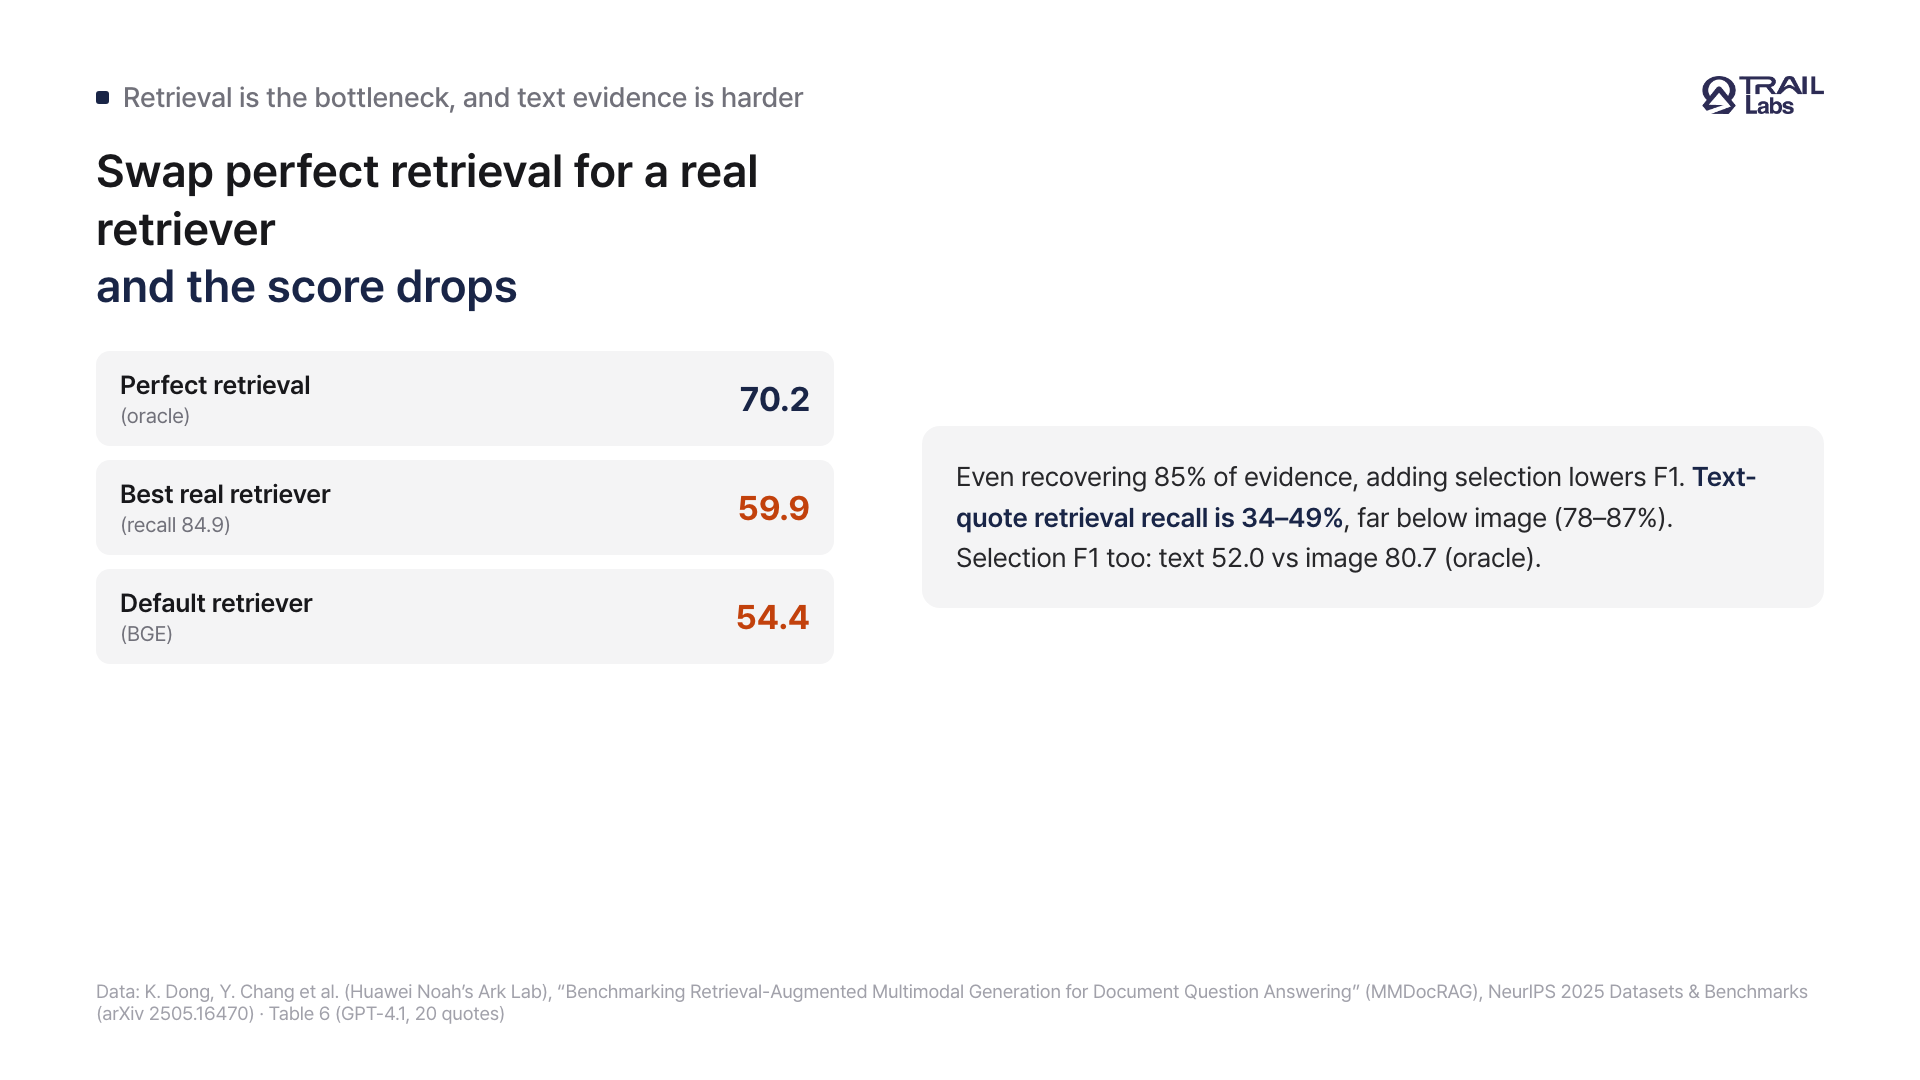
그림 2. oracle 대신 실제 retriever를 쓰면 점수가 빠진다. 텍스트 조각 recall(34–49%)이 이미지(78–87%)에 크게 못 미치는 것이 retrieval 단계의 병목이다 [1].
이미지는 OCR보다 VLM 설명이 낫다
문서 속 그림을 모델에 전달하는 길은 둘이다. OCR로 그림 안의 글자만 뽑아 넘기거나, VLM에게 그림을 글로 풀어 쓰게 해서 넘기는 것이다. 두 방식을 견줘 보니 VLM이 쓴 설명 쪽이 우세했다. quote selection F1 평균이 OCR 텍스트일 때 59.8, VLM 설명일 때 66.3이었다 [1].
차이는 텍스트의 길이와 담긴 정보에서 왔다. VLM 설명 길이가 OCR 대비 표에서는 0.5배, 그림에서는 2.8배 더 길었다. 저자들 설명으로는 OCR이 그림 안 요소의 배치와 관계를 흘리기 쉬운 데 비해, VLM 설명은 그런 multimodal 정보를 더 많이 보존했다 [1].
후보의 순서도 결과에 영향을 줬다. MMDocRAG는 gold 조각 위치를 후보 안에서 고르게 퍼뜨려 두었다. 그런데도 모델은 Lost in the Middle이 보고한 경향과 마찬가지로 앞쪽에 놓인 근거를 더 자주 집었다. gold가 맨 앞에 있을 때 선택될 확률이 가장 높았고 뒤로 밀릴수록 낮아졌으며, 이미지 조각에서 이 쏠림이 특히 심했다 [1][3].
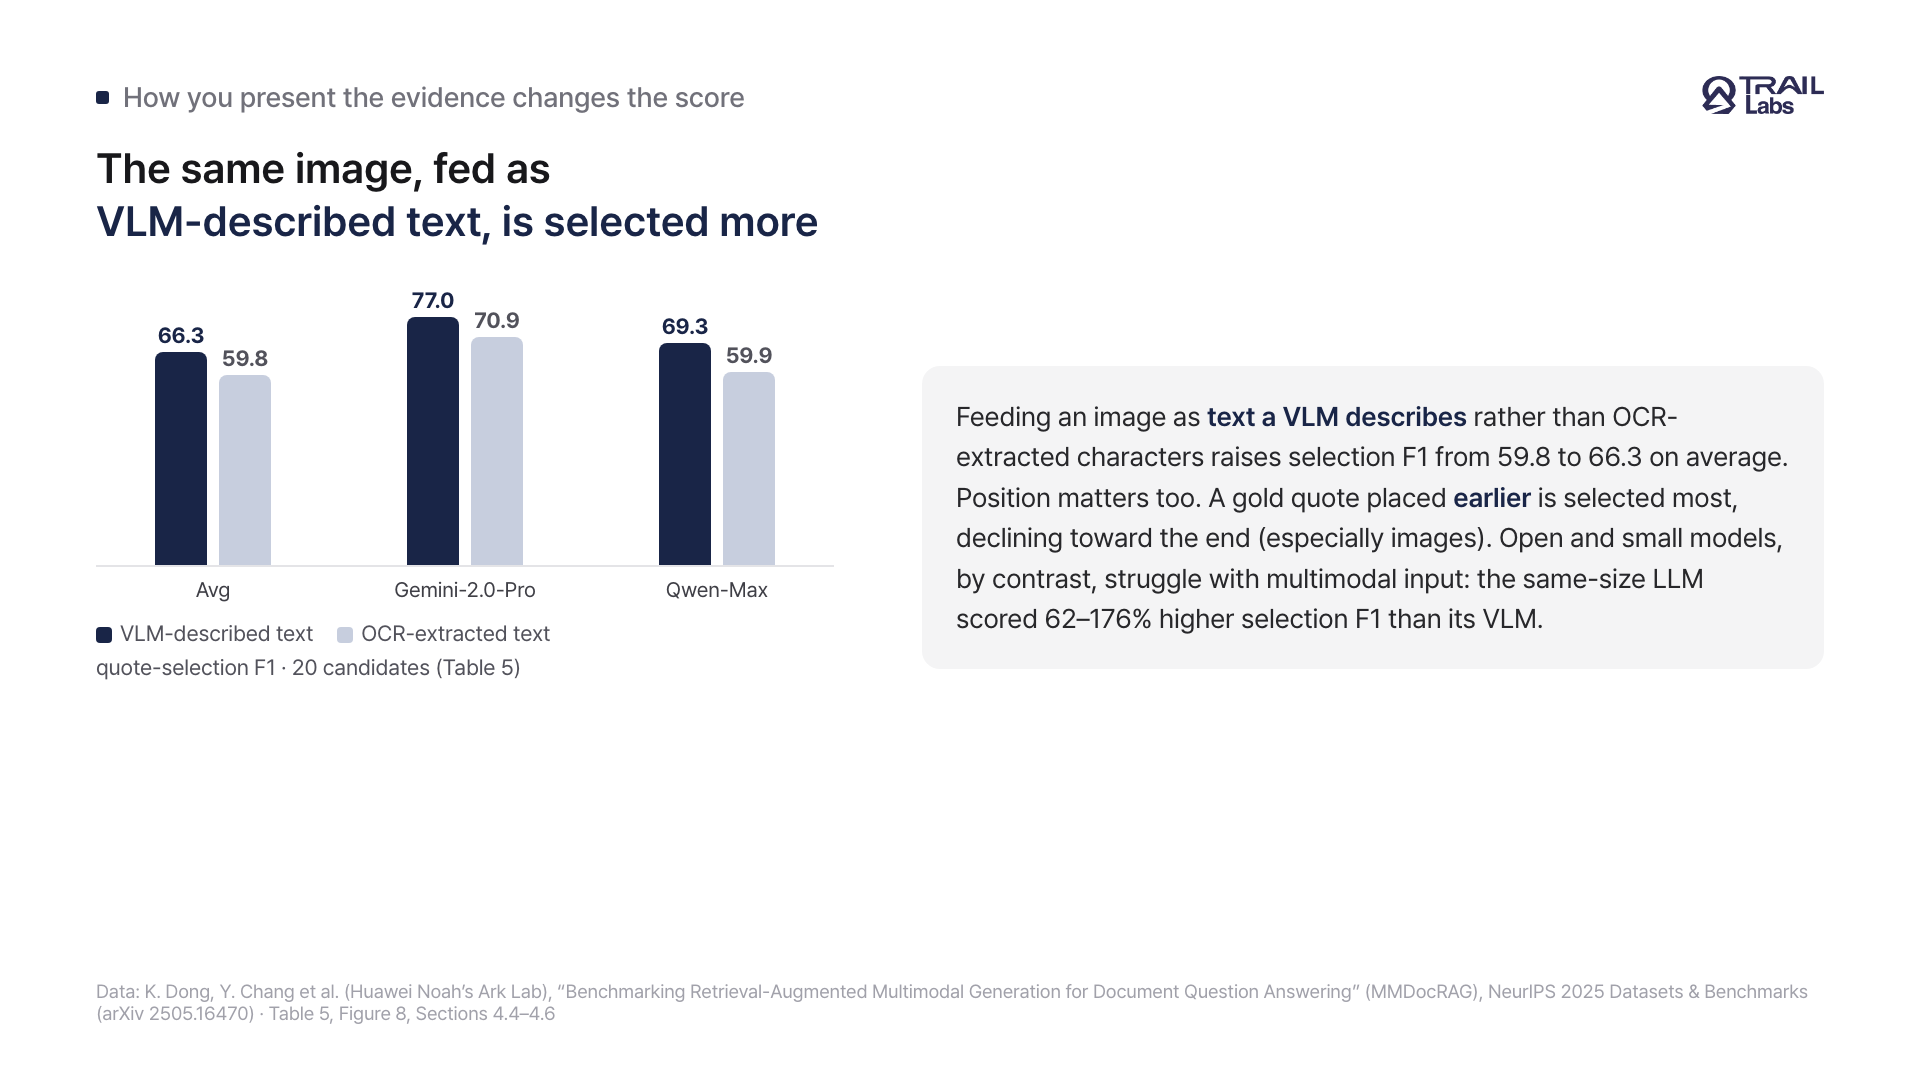
그림 3. 똑같은 그림이라도 OCR 글자 대신 VLM 설명문으로 넘기면 selection F1이 높아졌다(평균 59.8에서 66.3으로) [1].
실험 설계
평가 범위가 넓다. 상용 23개, 공개 37개로 모델 60개를 돌렸고, MMDocRAG 개발셋으로 fine-tuning한 모델 9개가 여기에 더해졌다. retriever는 텍스트 기반 6종, 시각 기반 4종, 하이브리드 4종으로 모두 14종을 맞붙였다. 후보 수는 15개, 20개 두 가지 설정을 썼고, 20개일 때 후보 전체 길이는 평균 3.6K 토큰 정도다 [1].
내가 문서 RAG를 짠다면
여기부터는 내 독해다. 문서를 다루는 retrieval 파이프라인을 짠다면 이 논문에서 세 가지를 가져가겠다.
첫째, 정답률 하나로 채점하지 않는다. retriever가 근거를 안 가져온 건지, 가져왔는데 모델이 안 고른 건지는 성격이 다른 문제다. MMDocRAG처럼 정답을 포함한 후보를 고정해 selection만 따로 재 보면, 54.4와 70.2 사이 어디서 점수가 새는지가 보인다. 이걸 가르지 않으면 좋은 retriever를 붙여도 reader가 범인일 때 엉뚱한 데를 고치게 된다.
둘째, 텍스트 근거를 먼저 의심한다. 직관과 반대로 이미지 조각(recall 78–87%, 선택 80.7)보다 텍스트 조각(recall 34–49%, 선택 52.0)이 양쪽에서 더 어려웠다. 표나 리스트에서 뽑은 짧은 텍스트 조각이 서로 비슷해 hard negative와 안 갈리기 때문으로 보인다. multi-format 문서가 많다면 텍스트 쪽 recall을 먼저 재고 올리는 게 모델 교체보다 상한선을 더 움직인다.
셋째, 이미지를 그대로 던지지 않는다. 같은 그림이라도 OCR 글자보다 VLM이 설명한 텍스트로 주면 선택 F1이 평균 6.5점 올랐다(59.8에서 66.3으로). 표·그림의 배치와 관계를 글로 풀어 주는 전처리는 retrieval을 안 바꾸고도 쓸 수 있는 저비용 레버다. 다만 모델·문서 유형마다 길이 대비 효과가 다르니 A/B는 해야 한다.
이 연구의 한계
이 벤치마크를 가져다 쓸 때 걸리는 점이 세 가지 있다. 우선 답 품질 채점을 LLM judge에 맡기는 부분이다. 저자들은 자동 지표보다 세밀한 평가를 노렸다고 적지만, judge 모델이 가진 편향까지 걷어 내지는 못한다. 다음으로 문서 222개가 10개 유형에 퍼져 있다고는 해도, 언어나 도메인이 한쪽으로 쏠려 있는지는 원문의 분포를 더 들여다봐야 판단할 수 있다. 마지막으로 hard negative를 retrieval 상위 결과에서 뽑았기 때문에, 지금 쓰이는 retriever의 성향이 난이도에 녹아 있다. retriever가 바뀌면 문제의 어려움도 함께 움직이므로, 이 벤치마크는 특정 시점의 난이도를 기록한 자료로 보는 편이 맞다 [1].
내가 덧붙이자면, end-to-end 숫자(54.4·59.9)는 GPT-4.1 한 모델을 끝까지 돌린 설정에서 나온 것이라 retrieval과 selection 중 어느 쪽이 더 병목인지는 모델이 바뀌면 비율이 달라질 수 있다. 그래서 나는 “70.2 대 54.4” 같은 절대값보다 “retrieval을 먼저 재야 한다”는 방향과 “OCR보다 VLM 설명”이라는 전처리 힌트만 내 설정으로 가져간다.
Kuicai Dong, Yujing Chang, Shijie Huang, Yasheng Wang, Ruiming Tang, Yong Liu, “Benchmarking Retrieval-Augmented Multimodal Generation for Document Question Answering” (MMDocRAG), NeurIPS 2025 Datasets & Benchmarks (arXiv 2505.16470).
References
- Kuicai Dong, Yujing Chang, Shijie Huang, Yasheng Wang, Ruiming Tang, Yong Liu (Huawei Noah’s Ark Lab), “Benchmarking Retrieval-Augmented Multimodal Generation for Document Question Answering” (MMDocRAG), NeurIPS 2025 Datasets & Benchmarks (arXiv 2505.16470)
- MMDocRAG 프로젝트 페이지
- Nelson F. Liu et al., “Lost in the Middle: How Language Models Use Long Contexts”, TACL 2024