



RAG는 답에 필요한 evidence 중 하나는 잘 가져오지만, 여러 개가 필요할 때 그걸 다 가져오는 경우는 드물다. news article 기반 질문 2,255개에서, top 10 chunk 안에 필요한 사실이 하나라도 든 경우는 82%였지만 필요한 사실이 전부 든 경우는 19%였다 [1]. MBZUAI와 Inception42(UAE) 연구진의 2026년 10월 arXiv 논문이고, 아직 peer review 전이다. 저자들은 RAG를 long-context 모델로 갈아치우자는 게 아니라 RAG의 구조적 한계를 측정 가능한 형태로 만드는 게 목적이라고 밝힌다 [1].
RAG를 production에 붙여본 사람이면 다 겪는 장면이 있다. 답이 틀렸는데 원인을 모른다. retriever가 필요한 문단을 안 가져온 건지, 가져왔는데 모델이 안 쓴 건지. 평소엔 정답 여부 하나로만 채점하니까 이 둘이 한 덩어리로 뭉개진다. 이 논문이 좋았던 건 그 둘을 떼어내서 각각 숫자로 보여줬다는 점이다. 아래는 arXiv v1의 본문과 Table 1·3·4·5, Figure 1–3을 2026년 10월 기준으로 읽고 숫자를 원문과 대조한 메모다. code나 데이터를 직접 돌려보지는 않았고, 저자들과 관계는 없다.
retrieval과 reading을 어떻게 가르나
저자들은 evidence-based generation(EBG)을 정의했다. 모델이 답만 내는 게 아니라 그 답을 뒷받침하는 input의 line number를 같이 내야 하고, 답(Ans)과 근거(Evid)가 둘 다 맞을 때만 정답(Ans+Evid)으로 친다 [1]. 이렇게 하면 “답은 맞는데 근거는 엉뚱한” 경우가 숨지 못한다. 설계로서 깔끔하다. 평가를 바꾸면 실패가 어디서 나는지가 비로소 보인다.
retrieval: 하나는 쉽고, 전부는 어렵다
먼저 retrieval이다. MultiHop-RAG은 news article 609개 위에서, 서로 다른 article에 흩어진 evidence 2–4개가 있어야 풀리는 질문들로 구성된다. 저자들은 article을 256-token window로 잘라 6,296개 chunk를 만들고, OpenAI text-embedding-3-large로 질문과의 similarity 순으로 정렬했다 [1].
결과는 any와 all 사이의 간극이다. top 10 chunk 안에 필요한 사실이 하나라도 든 경우는 82%, 전부 든 경우는 19%였다. multi-hop(inference) 질문만 보면 all이 8%까지 떨어진다. window를 top 50으로 넓히면 all 커버리지가 57%, top 100이면 71%가 된다 [1].
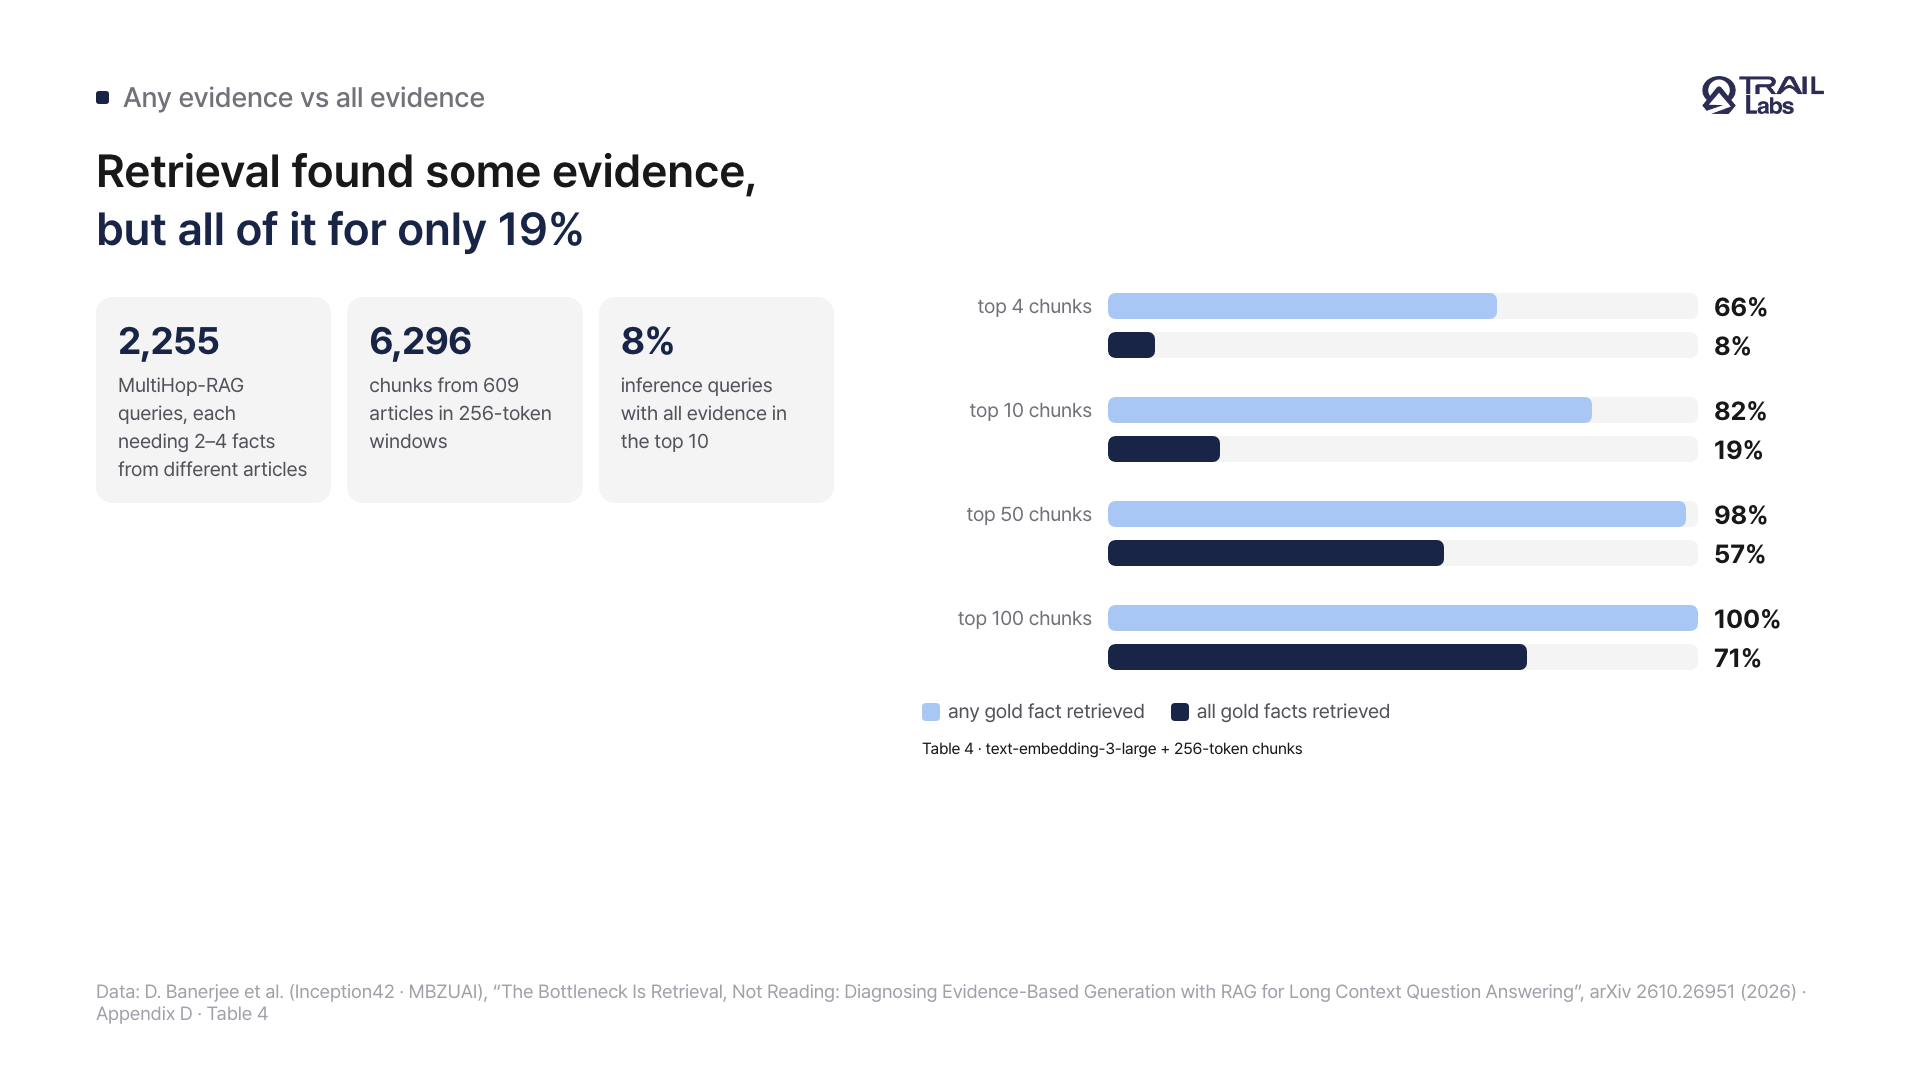
그림 1. 하나를 찾는 건 쉬웠고 전부를 찾는 건 어려웠다. top 10에서 두 비율은 82%와 19%였다 [1].
저자들은 all 커버리지를 RAG가 근거에 충실하게 답할 수 있는 상한선으로 읽는다. 필요한 사실이 하나라도 빠지면 그 답은 근거에 충실할 수 없으니, top 10 기준으로 inference 질문의 90% 이상은 모델을 부르기도 전에 이미 진 셈이다 [1]. 이 프레이밍이 핵심이다. 우리는 보통 LLM을 더 좋은 걸로 바꾸거나 prompt를 손보면서 reading 쪽을 만지는데, 정작 상한선은 그 앞 retrieval에서 이미 잘려 있다.
chunking: 문단에서 정체성을 떼어내면
두 번째 한계는 chunking이다. 문단 하나를 잘라내면 그게 어느 문서·어느 섹션에서 왔는지, 제목과 저자가 누구인지가 같이 떨어져 나간다. 저자들은 이걸 QASPER-MP로 쟀다. NLP 논문에 대한 질문 하나에 정답 논문 1개와 다른 논문 10개를 섞어 주고, 질문은 논문을 “Smith et al.” 같은 저자 성이나 제목 조각으로만 가리킨다 [1].
같은 11개 논문 pool 안에서, long-context 모델에 논문 전문을 준 조건(LC-EBG)이 최고 RAG 변형을 frontier 모델 5개 모두에서 judge score 0.05–0.13점 앞섰다. 총점이 비슷해 보인 건 RAG가 retrieval이 실패한 질문에서 아예 답을 포기했기 때문이다. 답할 수 있는 질문에서 RAG의 거부율은 24–40%, LC-EBG는 13–18%였다 [1].
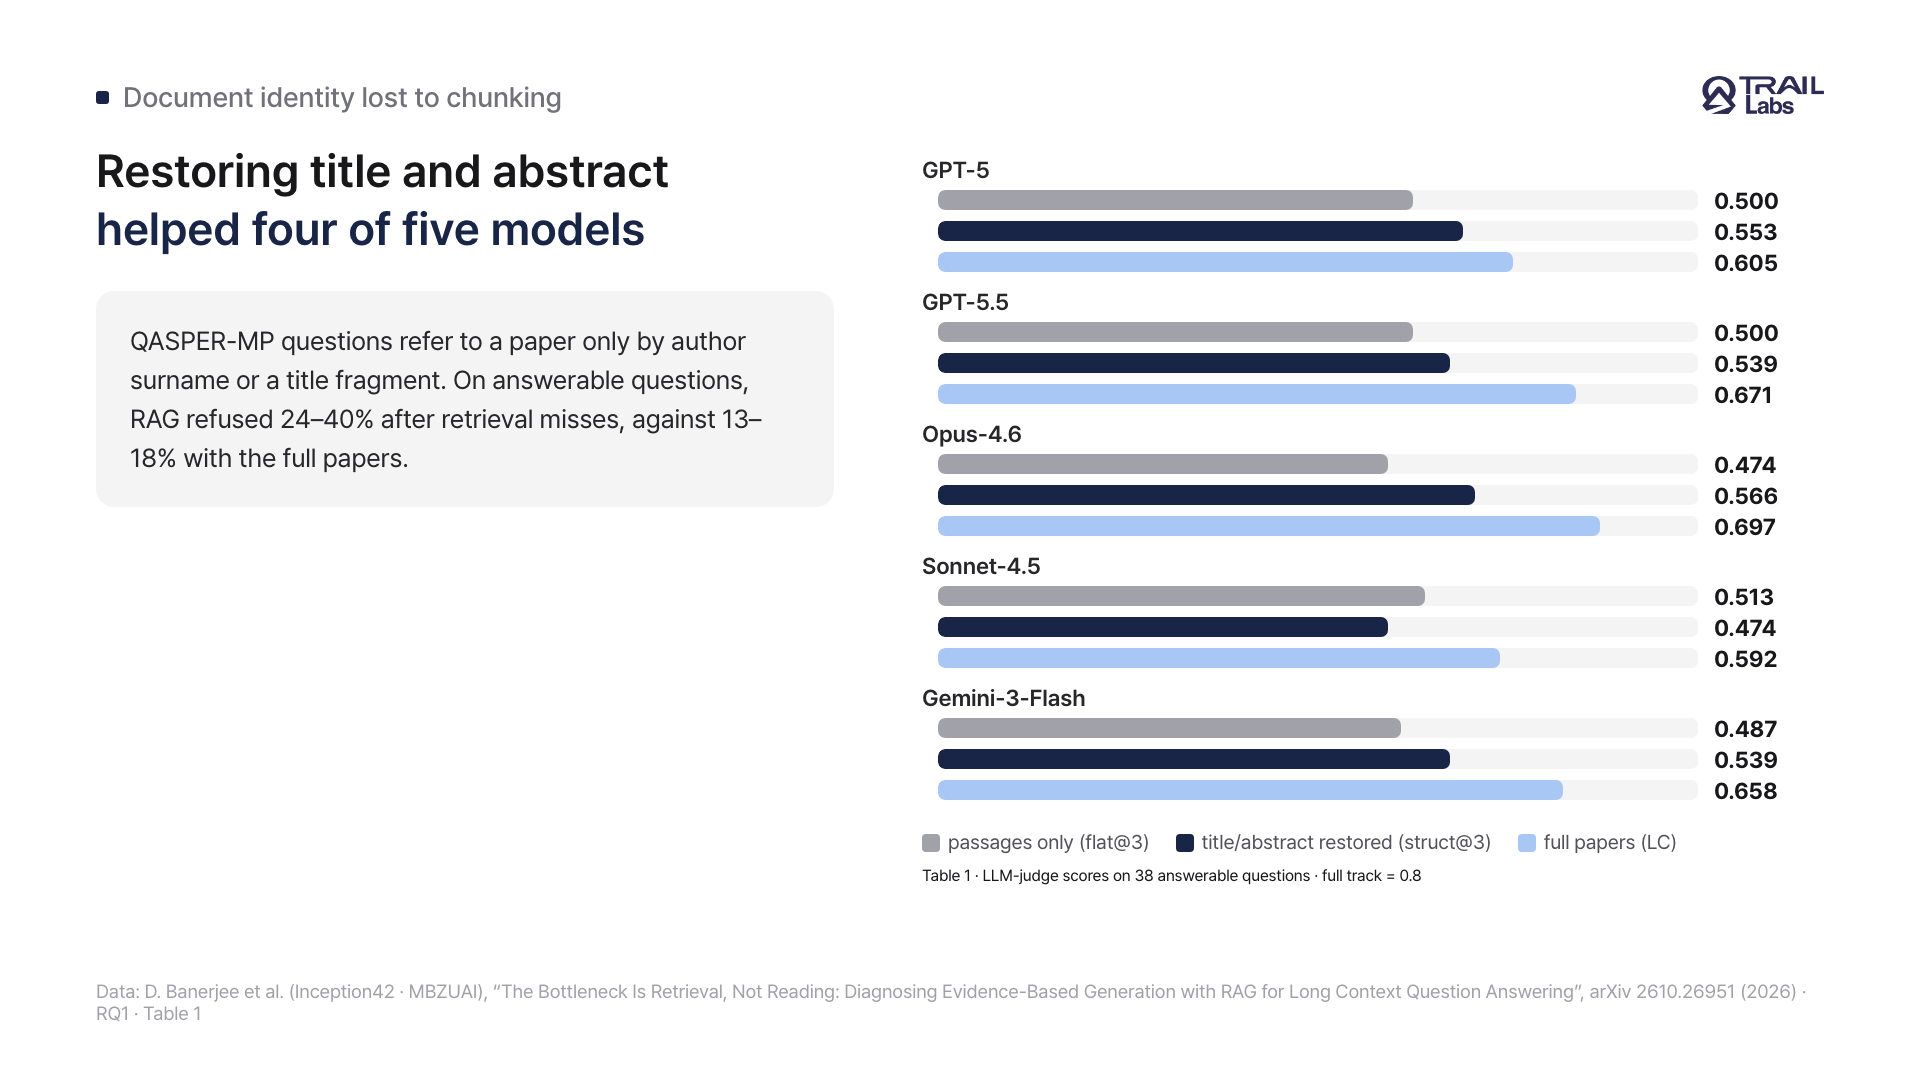
그림 2. retrieval한 passage를 title·abstract로 다시 감싸자 5개 모델 중 4개가 단순 concatenation보다 점수가 올랐다. 다만 논문 전문 조건에는 여전히 못 미쳤다 [1].
재미있는 건 structured 변형이다. 저자들은 top 3 passage를 순위대로 이어 붙인 것(flat)과, 그걸 원래 논문·title·abstract 구조로 다시 감싸고 빠진 부분을 표시한 것(structured)을 비교했다. Opus-4.6이 0.474에서 0.566으로, GPT-5가 0.500에서 0.553으로 올랐고, Sonnet-4.5만 0.513에서 0.474로 떨어졌다. 내용은 그대로 두고 passage에 출처 정체성만 돌려줬는데 모델이 가져온 걸 더 잘 썼다 [1]. retrieval 자체를 안 바꾸고도 상당 부분 복구된다는 뜻이라, 실무에서 당장 시도해볼 레버가 여기 있다.
답이 맞으면 evidence를 제대로 쓴 건가
답만 보는 채점은 “맞는 답이 틀린 근거 위에 서 있는” 경우를 못 본다. evidence 2개가 필요한 long-context 과제에서, Gemini-3-Flash(99.5%, 99.8%)와 GPT-5(95.1%, 98.6%)는 둘 다 잘 인용했다. 반면 GPT-4o는 첫 번째 evidence는 71.3% 인용했지만 두 번째는 20.9%였고, Sonnet-4.5도 64.6%와 21.4%로 같은 쏠림을 보였다 [1].
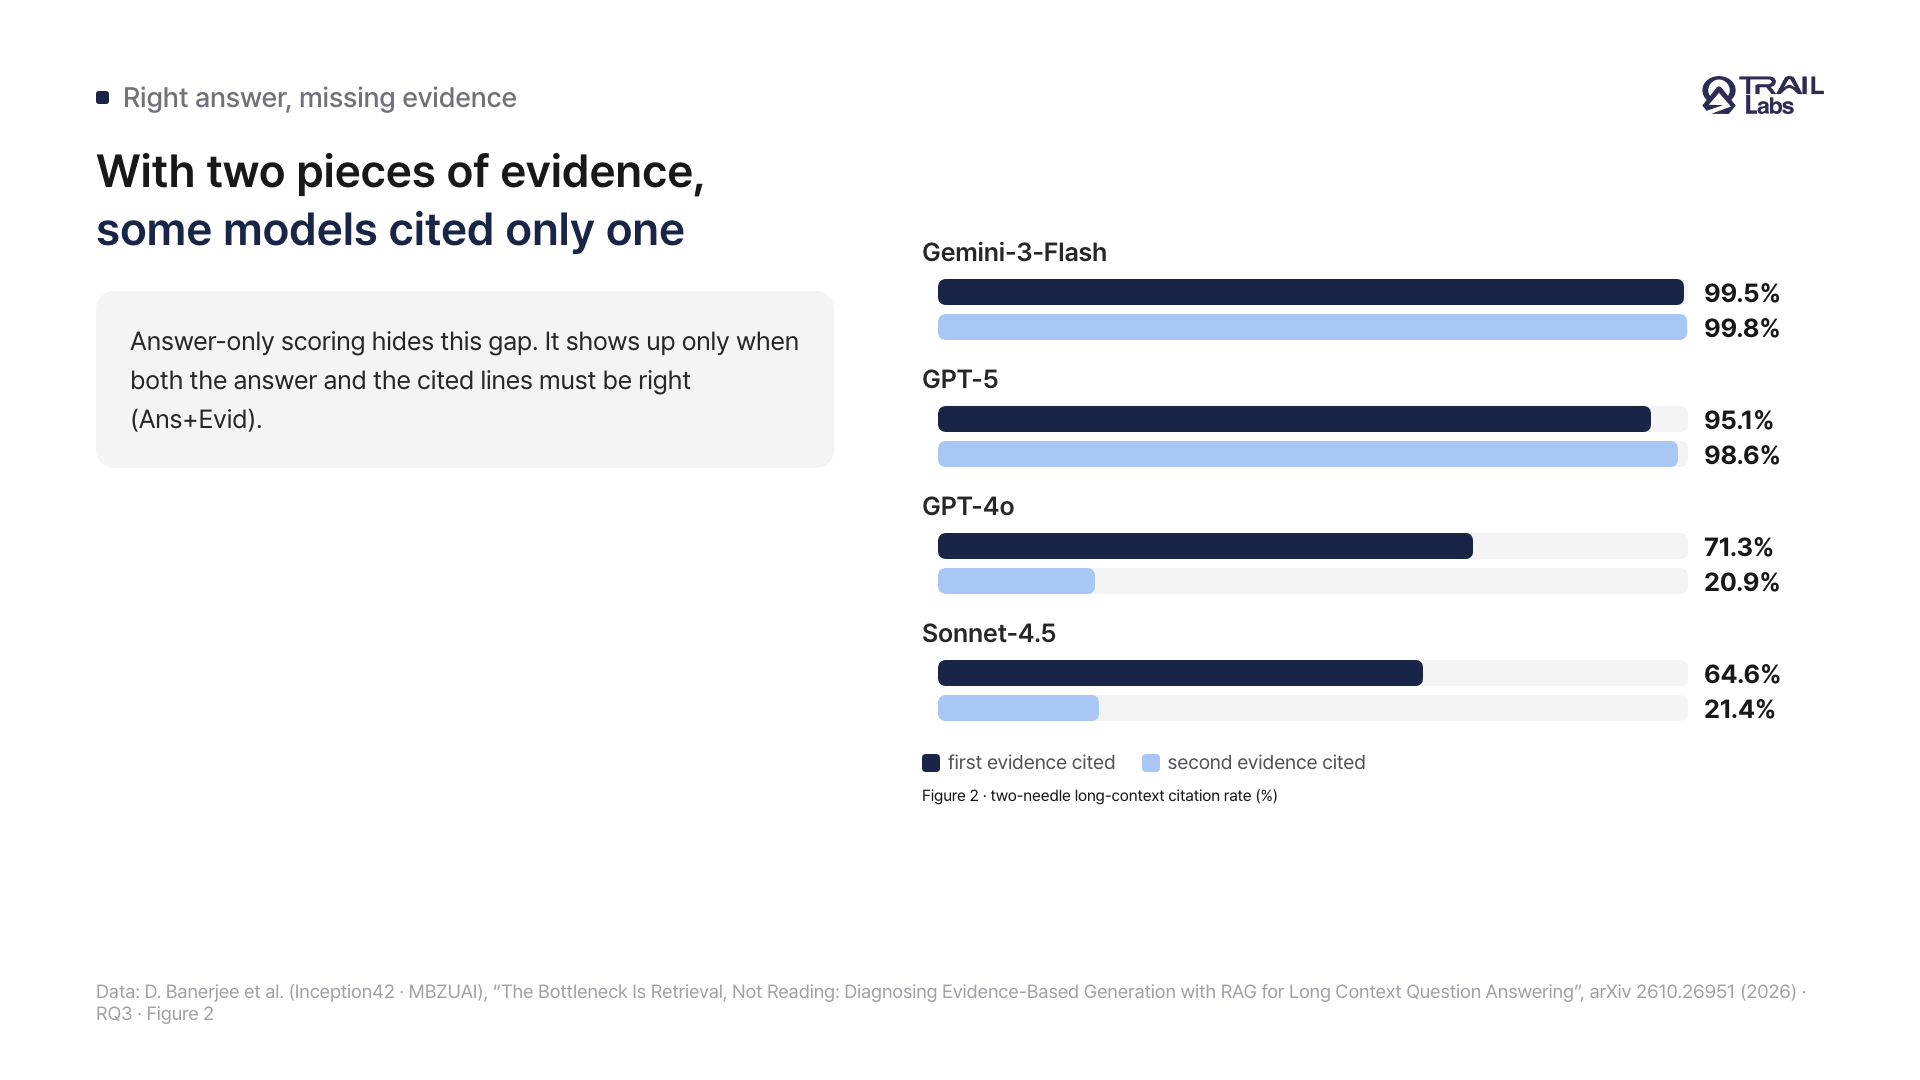
그림 3. 같은 과제에서 어떤 모델은 두 evidence를 고르게 인용했고 어떤 모델은 하나만 인용했다. 답만 보는 채점으로는 이 차이가 안 보인다 [1].
context 안의 evidence가 모델이 이미 아는 지식과 어긋날 때 간극은 더 벌어졌다. 모델은 그걸 정당화해줄 context를 제대로 인용하지 않고도 기대된 답에 도달했다. 저자들은 정답률만으로는 모델이 long-context evidence를 얼마나 충실히 썼는지를 크게 부풀려 말할 수 있다고 결론짓는다 [1]. 근거를 요구하는 것 자체도 답을 끌어올렸다. citation을 요구한 prompt는 답만 요구한 prompt보다 300K–900K character context에서 Sonnet·Gemini 계열의 정답률을 9–19점 올렸다. distractor가 짧고 분명한 쉬운 synthetic 과제에서는 차이가 없었다 [1].
내가 RAG를 짠다면 뭘 바꾸겠나
여기부터는 내 독해다. 이 논문은 RAG를 만드는 쪽 이야기지만, 세 가지는 당장 설계에 반영할 만하다.
첫째, 정답률 하나로 보지 않는다. EBG처럼 답과 근거를 같이 받게 하면 retriever 실패와 reader 실패가 갈라져서, 어느 쪽을 고칠지가 분명해진다. lab에서 한 번 맞히는 것과 매일 돌아가는 것의 차이는 늘 이 지점에서 난다.
둘째, retrieval을 reading보다 먼저 의심한다. top 10에서 all 커버리지가 19%라면, 아무리 좋은 모델을 붙여도 그 질문의 80%는 근거가 다 모이지 않은 채 답하게 된다. multi-fact 질문이 많은 도메인이라면 window를 넓히거나(top 50에서 57%), query rewriting·hybrid search로 recall을 먼저 올리는 게 모델 교체보다 상한선을 더 움직인다.
셋째, chunk에 정체성을 돌려준다. structured 조건이 retrieval을 안 바꾸고도 점수를 올렸다는 건, chunk를 그냥 이어 붙이지 말고 출처 title·section 같은 scaffolding을 다시 씌우라는 저비용 처방이다. Sonnet처럼 역효과가 난 모델도 있으니 모델별로 A/B는 해야 한다.
이 연구의 한계
저자들이 밝힌 한계부터. benchmark는 synthetic이거나 semi-synthetic이라 실제 법률·의료·과학 문서의 복잡성을 다 담지 못하고, evidence는 span level이 아니라 line level로 채점된다. MultiHop-RAG·QASPER-MP의 frontier 모델 실험은 50문항 pilot이다. query rewriting·hybrid search·adaptive context selection 같은 retrieval 변형은 다루지 않았고, 이것들이 상한선을 바꿀 수 있다 [1].
하나 더 짚을 건 비교 조건이다. MultiHop-RAG 비교에서 long-context 조건은 gold article을 다 받은 반면 RAG는 전체 corpus를 뒤져야 했으니 후보 pool이 다르다. 저자들도 top 10의 26–34점 격차에는 open-corpus retrieval의 비용이 포함돼 있고, 이를 RAG 대 long-context의 본질적 차이로 읽으면 안 된다고 명시한다. 실제 generative search engine이 어떤 chunk 크기·retrieval 방식을 쓰는지도 이 논문의 범위 밖이다 [1]. 그래서 나는 이 숫자를 “내 production 설정에서의 상한선”이 아니라 “retrieval을 먼저 재야 한다는 방향”으로만 가져간다.
Debopriyo Banerjee et al., “The Bottleneck Is Retrieval, Not Reading: Diagnosing Evidence-Based Generation with RAG for Long Context Question Answering”, arXiv 2610.26951 (2026).